
- 분류 전체보기 (359)

- SQL (2)
- JAVA (6)
- REACT (3)
- OS (24)
- AI(ML & DL) (37)
- BLOCKCHAIN (15)
- ARCHITECTURE (7)
- BACKJOON (7)
- DOCKER (10)
- 취업 (1)
- GCP (8)
- TYPESCRIPT (10)
- MOBILE PROGRAMING (20)
- DATABASE DESIGN (18)
- AI(GNN) (2)
- ALGORITHM (14)
- CLAUD COMPUTERING (13)
- PYTHON (3)
- SPRING BOOT (13)
- INFLEARN (63)
- AI(MCP) (2)
- NETWORK (22)
- CODINGTEST (3)
- 기타 (6)
- STUDYING (49)
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- LLM
- architecture
- Spring
- 배포
- inflearn
- Algorithm
- springboot
- blockchain
- http
- CS
- TypeScript
- spring boot
- Python
- frontend
- Rag
- Studying
- GCP
- Kotlin
- Android
- cloud
- AI
- DL
- OS
- java
- DB
- Network
- docker
- Database
- SQL
- Design
- Today
- Total
소소한 지식 저장소
[STUDYING] 37. 생성형 AI 서비스 개발의 이해/활용 (LangChain)_Day1_핵심 정리 본문
1. Introduction
AI Application 개발이란
AI 애플리케이션 개발은 사전에 정의된 규칙에 따라 동작하는 전통적인 소프트웨어와 달리, 데이터 학습 모델(ML/DL/LLM)을 핵심 엔진으로 탑재하여 사용자의 맥락을 이해하고 실시간으로 최적의 예측·추론·행동을 수행하는 지능형 시스템을 구축하는 과정이다.
전통적 SW vs AI 모델 vs AI Application vs AI Agent 비교
| 비교 항목 | 전통적인 S/W 개발 | AI 모델 개발 | AI Application 개발 | AI Agent 개발 |
| 핵심 패러다임 | 규칙 기반(Rule-based), 결정론적 구조 | 데이터 기반(Data-driven), 패턴 학습 및 추론 | 문맥 기반(Context-based), AI 모델 인터페이스 통합 | 목표 기반(Goal-oriented), 자율적 실행 및 루프 |
| 기본 작동 방식 | 개발자가 명시한 로직대로 입력값 처리(IF-THEN, 알고리즘 순차 실행) | 대규모 데이터로 특징과 규칙 학습(통계적 패턴 학습·확률적 추론) | 파운데이션 모델에 RAG를 결합해 답변 생성(프롬프트+검색+API 파이프라인) | 목표가 주어지면 스스로 계획을 세우고 도구를 사용해 완수(Perceive→Plan→Act→Reflect) |
| 개발자의 주요 역할 | 비즈니스 로직 설계, DB 모델링, UI/UX 구현 | 데이터 전처리, 모델 아키텍처 설계, 학습·파인튜닝 | 프롬프트 엔지니어링, RAG 파이프라인·백엔드 연동 | 에이전트 페르소나 정의, 도구 배치, 멀티 에이전트 협업 설계 |
| 자율성 및 판단력 | 없음(설계된 분기문대로만 작동) | 낮음(정해진 확률적 결과만 수동적 출력) | 보통(주어진 문맥과 프롬프트 안에서 유연하게 판단) | 높음(실패 시 대안을 찾고 도구 사용 여부를 스스로 결정) |
| 외부 도구 활용 | 코드로 지정해 둔 기능만 수동 호출 | 모델 내부 연산만 수행(외부 도구 직접 호출 불가) | 설계된 파이프라인에 따라 필요한 텍스트 생성 | 상황을 보고 스스로 어떤 API/도구를 쓸지 선택 |
| 운영 및 관리(XOps) | DevOps(CI/CD, 서버 인프라 모니터링) | MLOps(데이터/모델 드리프트 감지, 재학습 파이프라인) | LLMOps(토큰 비용 최적화, 환각률 제어, 프롬프트 관리) | AgentOps(무한 루프 방지, 도구 호출 성공률, 자율성 가드레일) |
| 대표적인 도구 | Java, Python, Spring, React, PostgreSQL 등 | PyTorch, TensorFlow, Hugging Face, CUDA 등 | LangChain, LlamaIndex, OpenAI API, Pinecone, Chroma 등 | AutoGen, CrewAI, LangGraph, AgentOps 등 |
LangChain · RAG · LangGraph — 과정에서 다룰 세 축
| 축 | 핵심 기능 | 지향점 |
| LangChain | LCEL과 체인 구성 / 프롬프트 엔지니어링과 구조화된 출력 / 도구 바인딩과 대화 메모리 관리 | LLM 제어 및 선형적인 AI 애플리케이션 파이프라인 구축 |
| RAG | 데이터 전처리(ETL) 및 벡터DB 적재 / 고급 검색 기술(Advanced Retrieval & Re-ranking) / 컨텍스트 주입 및 할루시네이션 제어 | 기업 내부 데이터 및 비정형 문서를 활용한 지식 기반 서비스 개발 |
| LangGraph | 상태(State) 기반 순환 그래프 설계 / 영속성과 동적 인터럽트 / 멀티 에이전트 오케스트레이션 | 복잡한 상태를 제어하고 스스로 판단·성찰하는 자율형 멀티 에이전트 구축 |
AI 제품의 6단계 진화
| 단계 | 변화 내용 | 예시 |
| 1단계. 백그라운드 ML (2016~2022) | AI인지도 모르고 편익을 누리던 '비가시성'의 시대 | Google 번역, YouTube 추천 — 모델이 기존 UI 뒤에서 조용히 핵심 기능 지원. 실제 예시로 일본어 안내문(現金のみ)을 카메라로 비추면 "cash only"로 실시간 번역되는 구글 번역 화면을 시연 |
| 2단계. 채팅 (2022년 말) | AI가 전면에 등장하며 인간의 언어를 이해하기 시작한 '소통'의 시대 | ChatGPT — AI 모델이 제품의 전경으로 등장하며 대화가 주된 제품이 됨 |
| 3단계. RAG (2023) | AI의 고질적 문제인 환각(Hallucination)을 해결하고 실시간 정보·기업 내부 데이터를 연결하며 '비즈니스 활용 가능성'을 입증한 결정적 단계 | 웹 검색을 사용하는 ChatGPT — 외부 문맥을 추가해 AI 모델의 품질과 신뢰도를 향상 |
| 4단계. Foreground 에이전트 (2024~2025) | 단순한 답변가를 넘어 AI가 스스로 계획을 세우고 도구를 사용해 실제 업무를 수행하며, 사용자는 진행 중간에 개입해 방향을 조정하는 협업형 에이전트 단계 | 맞춤형 여행 플래너(Mindtrip, Layla) — 사용자의 예산과 취향을 듣고 항공권/호텔을 조회해 여러 루트를 생성, 컨펌 받아 예약을 진행 |
| 5단계. Background 에이전트 (2025~) | 사용자가 잠든 사이에도 AI가 수천 개의 이메일을 분류하고 보고서 초안을 작성해 두는 시대. 인간은 '작업자'에서 '검토자(Reviewer)'로 역할 변화 | 자율형 소프트웨어 엔지니어(Devin) — 이슈 하나만 던져두면 밤사이 코드를 수정하고 테스트를 마친 뒤 결과를 보고 |
| 6단계. Agent2Agent 생태계 (진화 중) | AI가 사람을 대신해 다른 서비스의 AI와 직접 대화하고, 협상하며, 거래하는 단계 | Google의 A2A 프로토콜 — 서로 다른 앱의 에이전트들이 정보를 주고받을 수 있는 오픈 표준 프로토콜을 제안 |
Rag란?
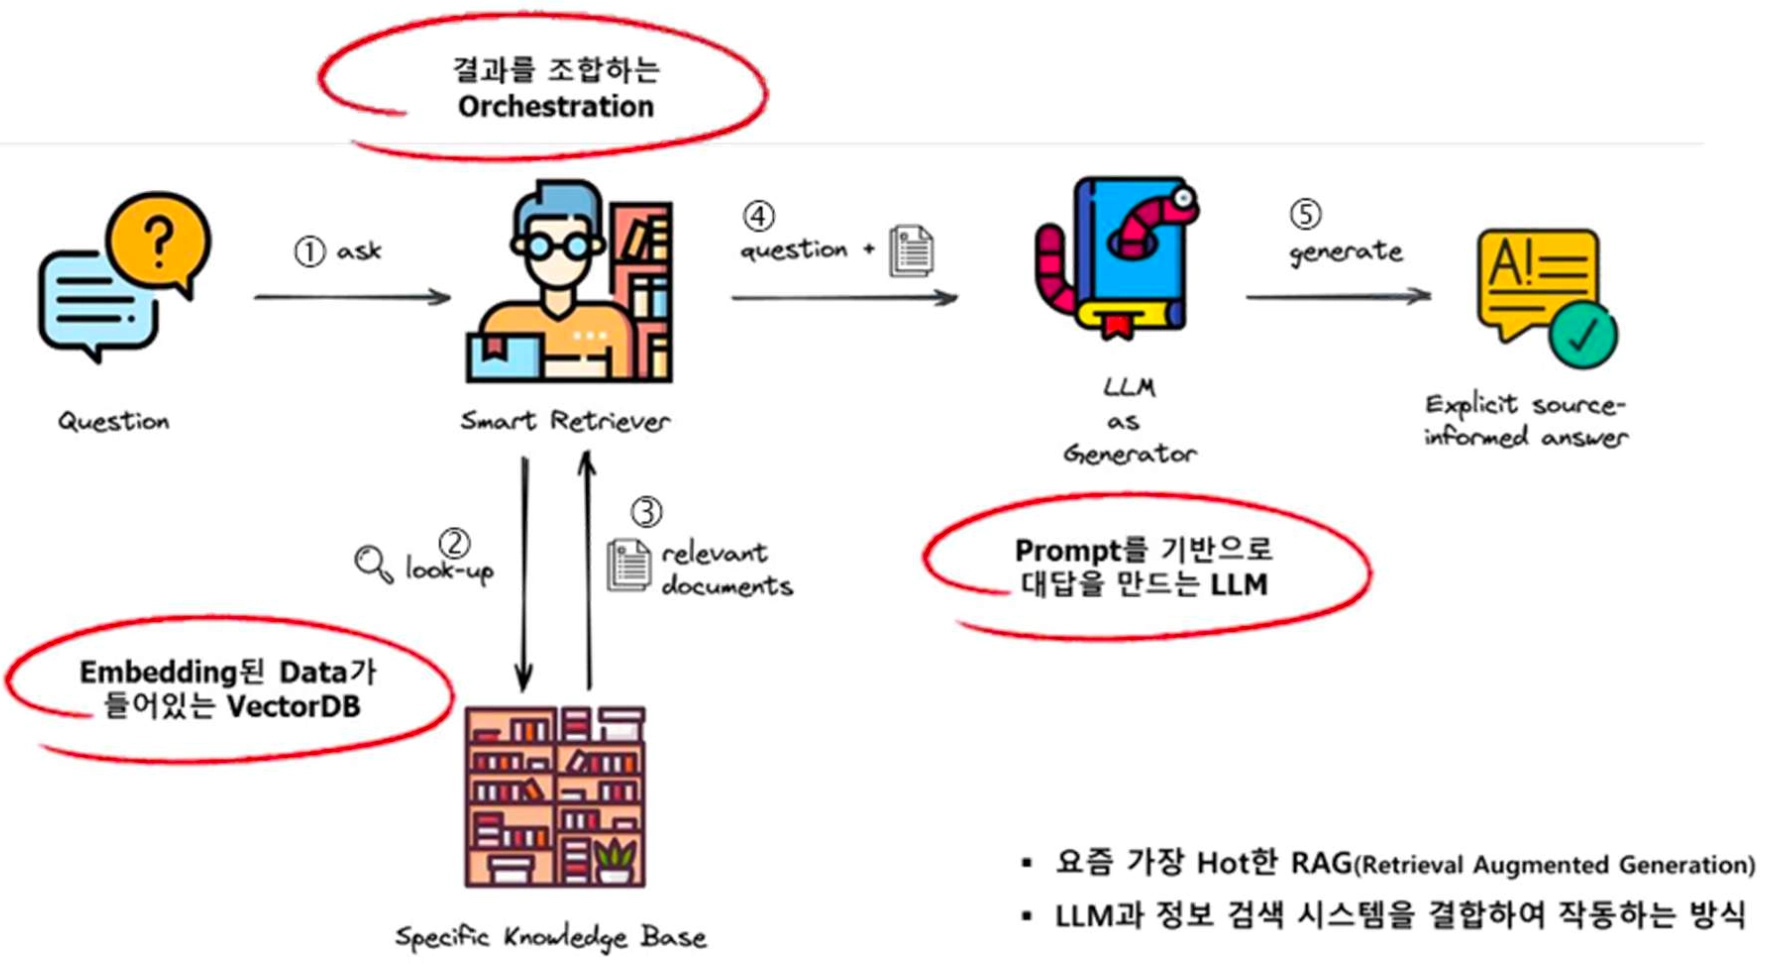
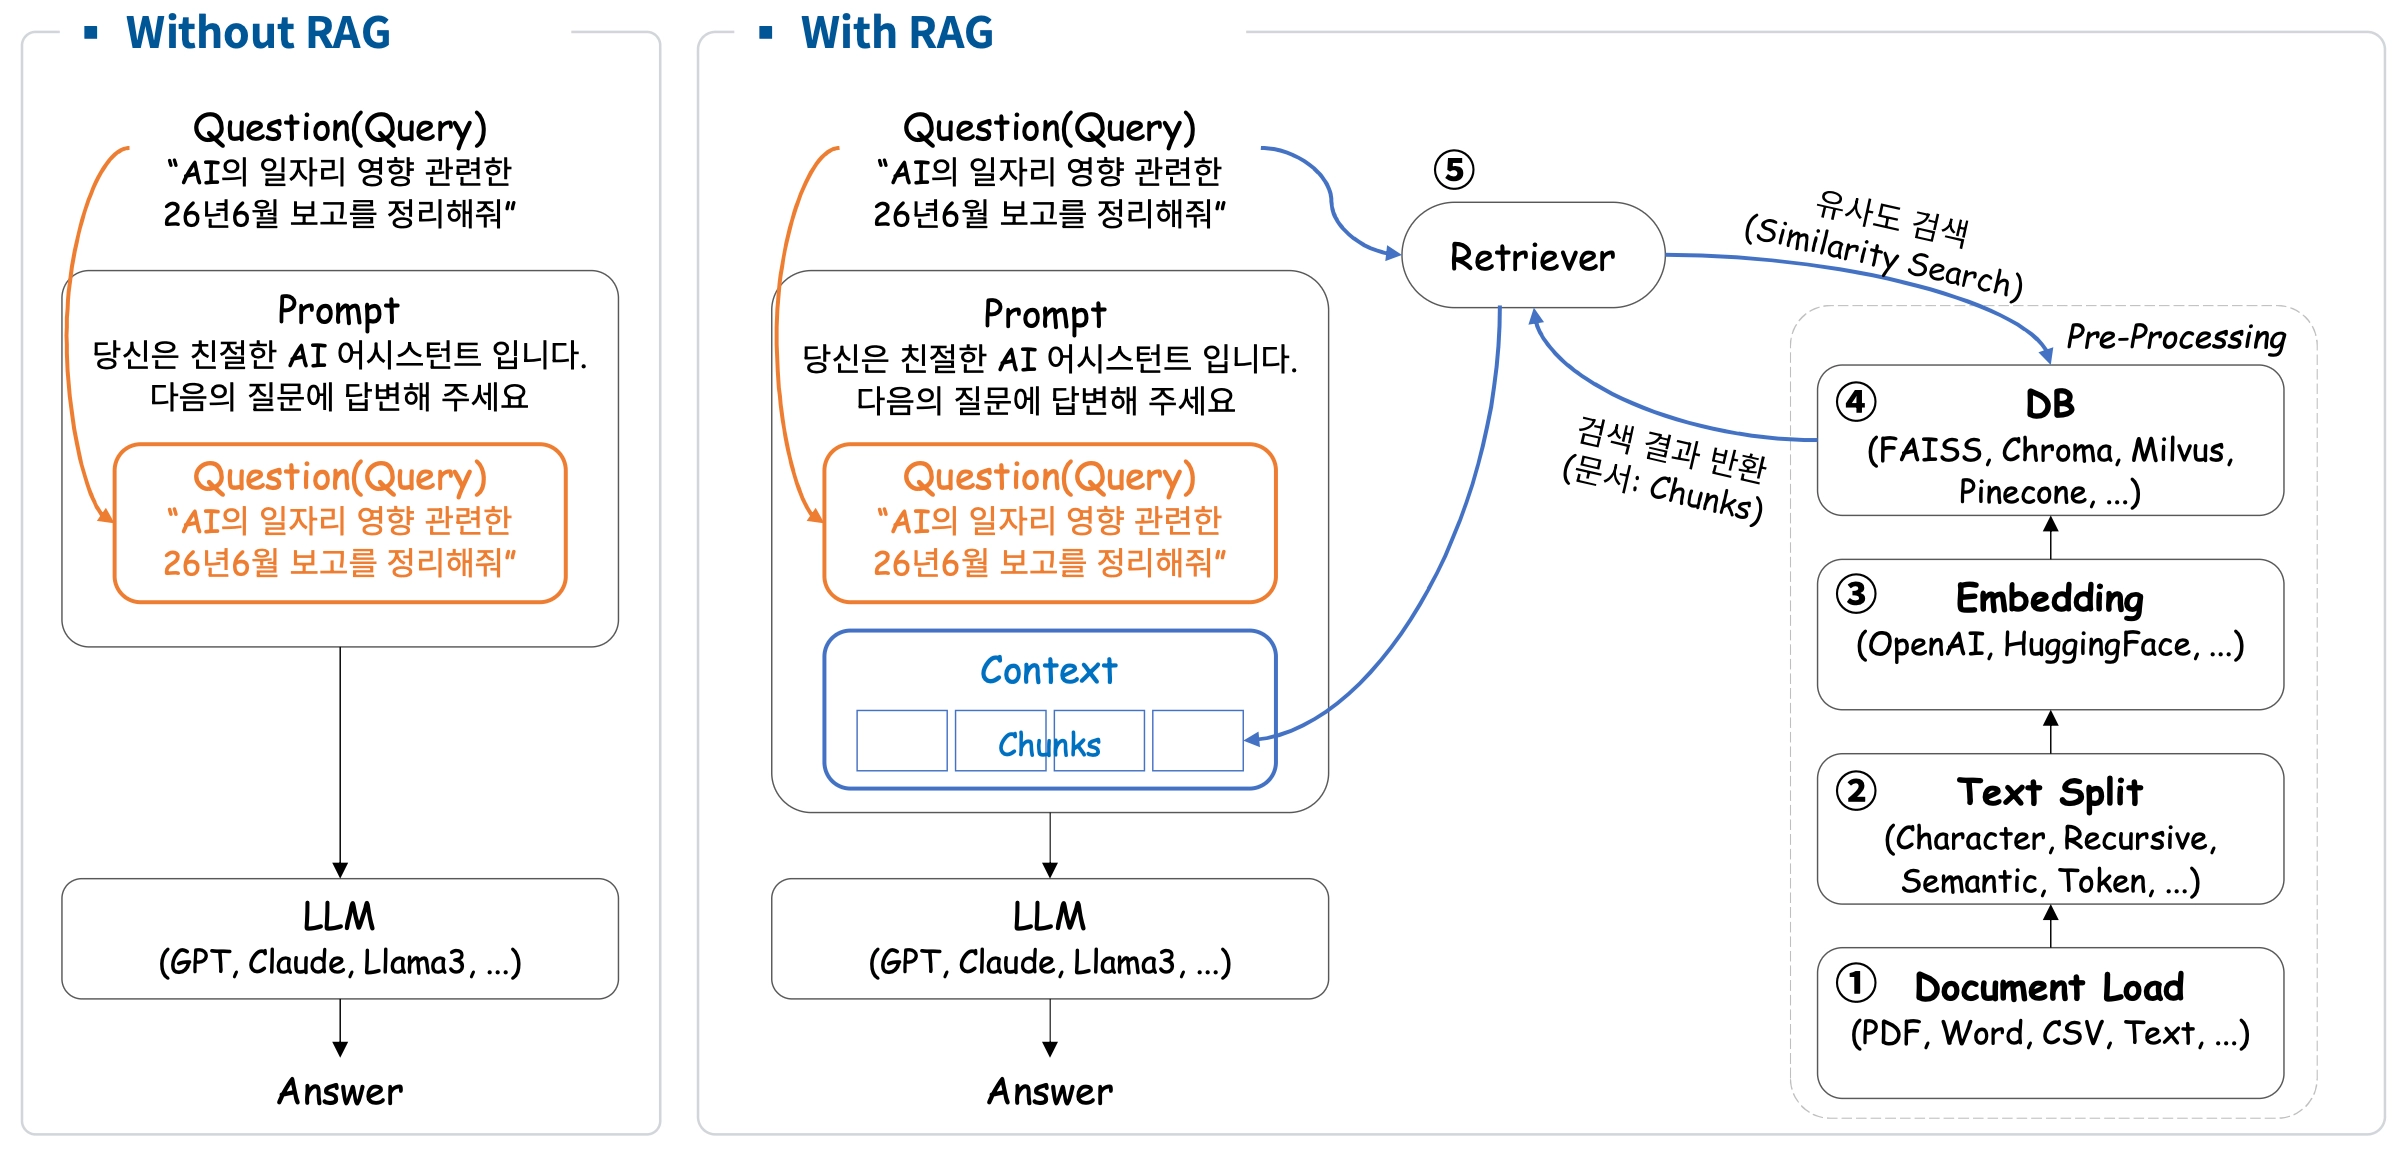
Agent란?
사용자나 다른 시스템을 대신하여 환경과 상호작용하며, 주어진 목표를 달성하기 위해 자율적으로 추론하고 계획하여 작업을 수행하는 지능형 시스템. 핵심 속성은 자율성, 목표 지향성, 추론 능력, 환경 인식, 도구 활용이다.
→ 목표를 도달하기 위해서 무한루프에 빠질 위험이 있음
| 기관 | 정의 |
| 세상을 관찰하고 자신이 사용할 수 있는 도구들을 이용해 행동함으로써 목표를 달성하려고 시도하는 애플리케이션 | |
| Nvidia | 높은 수준의 목표에 따라 복잡한 작업을 자율적으로 추론하고, 계획하고, 실행하도록 설계된 고급 AI 시스템 |
| IBM | 사용자나 다른 시스템을 대신하여 자율적으로 작업을 수행할 수 있는 시스템 또는 프로그램. 자신의 워크플로를 설계하고 사용 가능한 도구를 활용해 작업을 수행 |
| AWS | 환경과 상호작용하고 데이터를 수집하며, 사전 결정된 목표를 달성하기 위해 필요한 작업을 스스로 결정해 수행할 수 있는 소프트웨어 프로그램 |
Agent vs LLM — 왜 도구가 필요한가
"파리의 현재 날씨는?"이라는 질문에, 도구가 없는 LLM은 학습 시점의 지식에 기반해 근거 없는 답을 지어내는 환각(hallucination) 위험이 있다. 반면 WebSearch Tool을 가진 Agent는 실제 최신 데이터를 조회해 정확한 값을 답한다. 도구의 유무가 곧 사실에 기반한 답변과 그럴듯한 추측의 차이를 만든다.
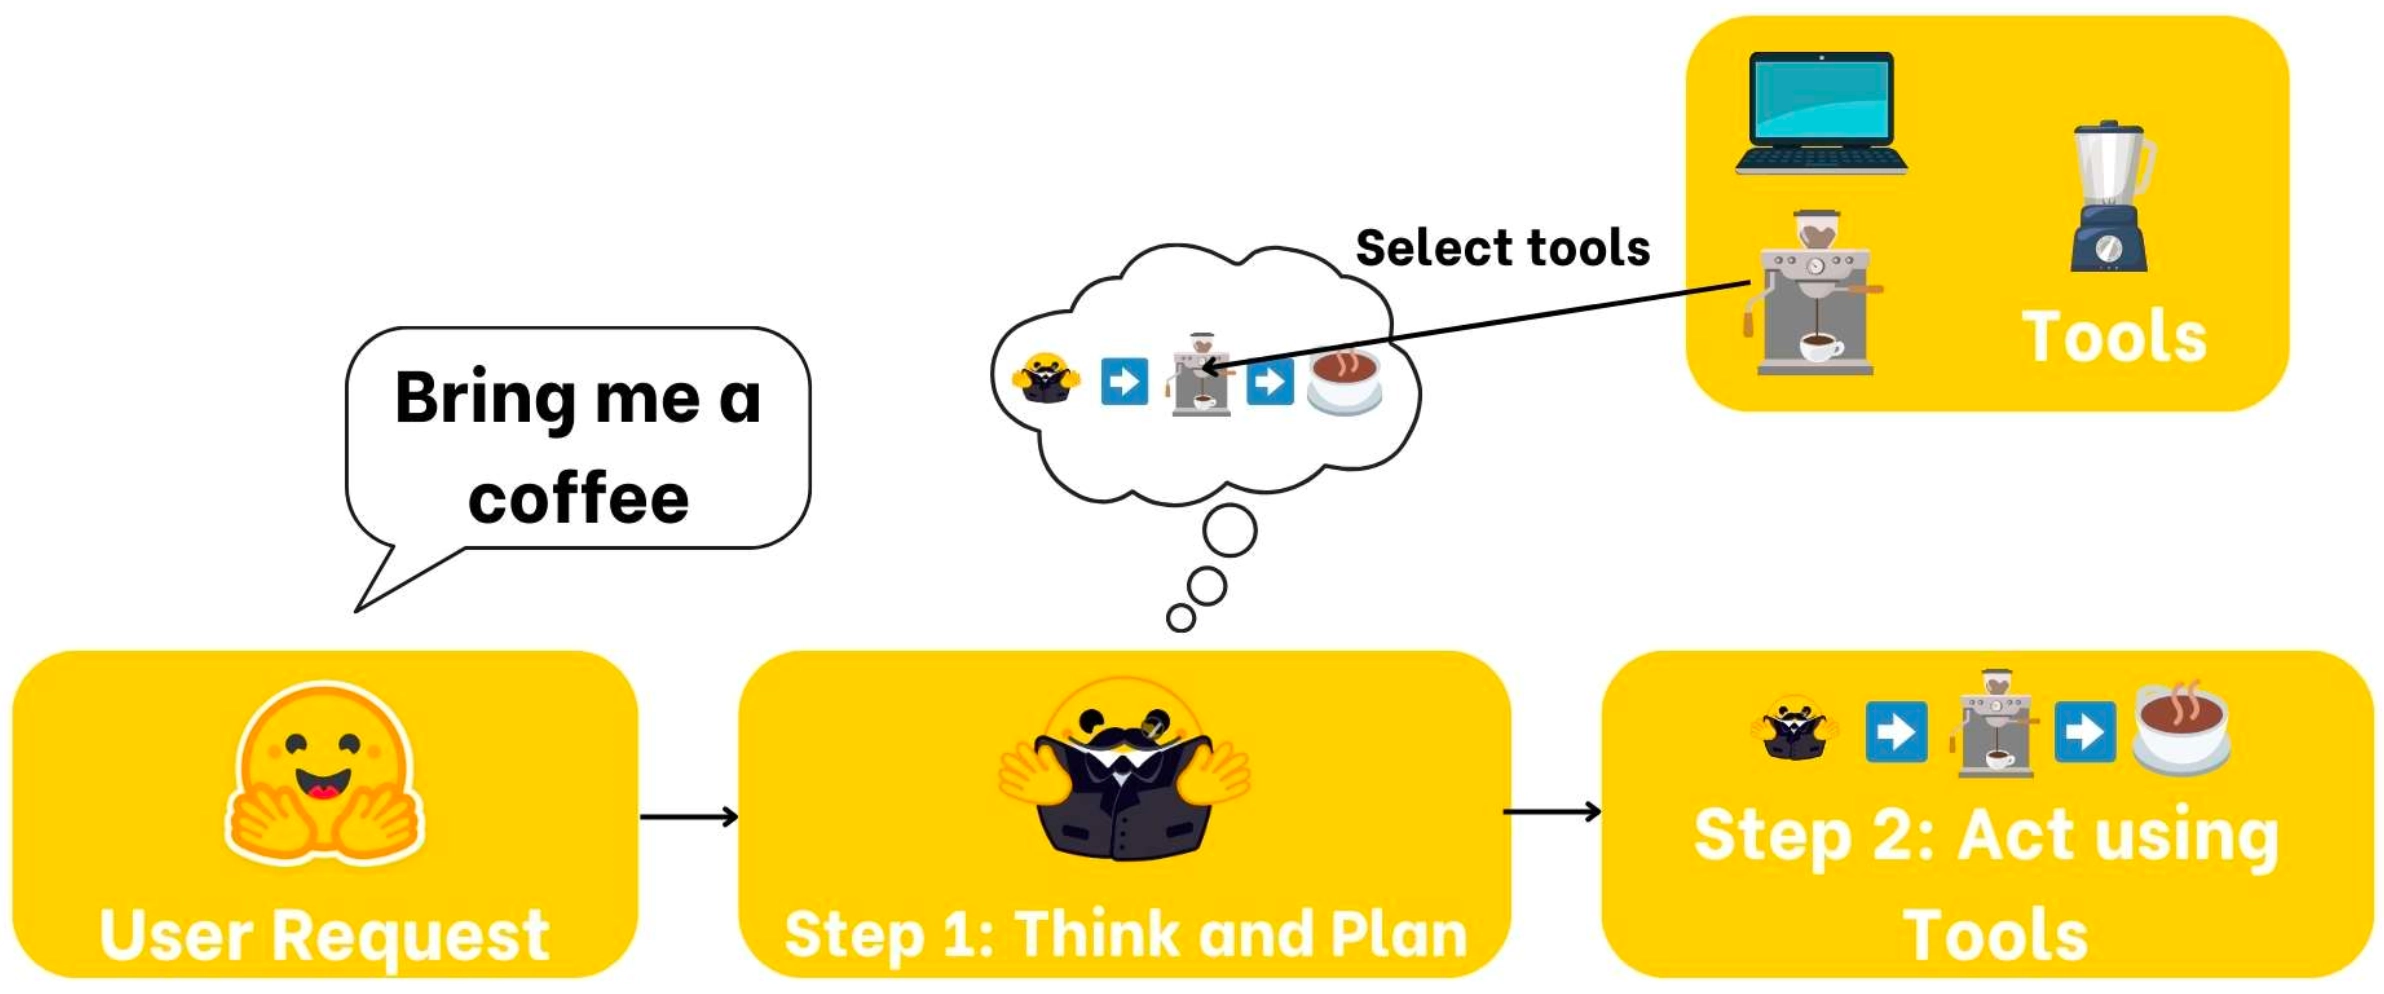
Agent 비유 — 집사 Alfred
Hugging Face 자료의 비유: 사용자가 "커피 부탁해"라고 요청하면 집사 Alfred는 먼저 생각하고 계획(Reason and plan)하며 자신의 도구함(Toolbox)에서 필요한 도구를 떠올린다. 이후 Execute 단계에서 실제로 주방에 가 커피를 준비해 전달한다. 에이전트의 사고(Reason)→행동(Execute) 흐름을 사람이 이해하기 쉬운 서사로 보여주는 예시다.
ReAct: Thought → Act → Observe 사이클
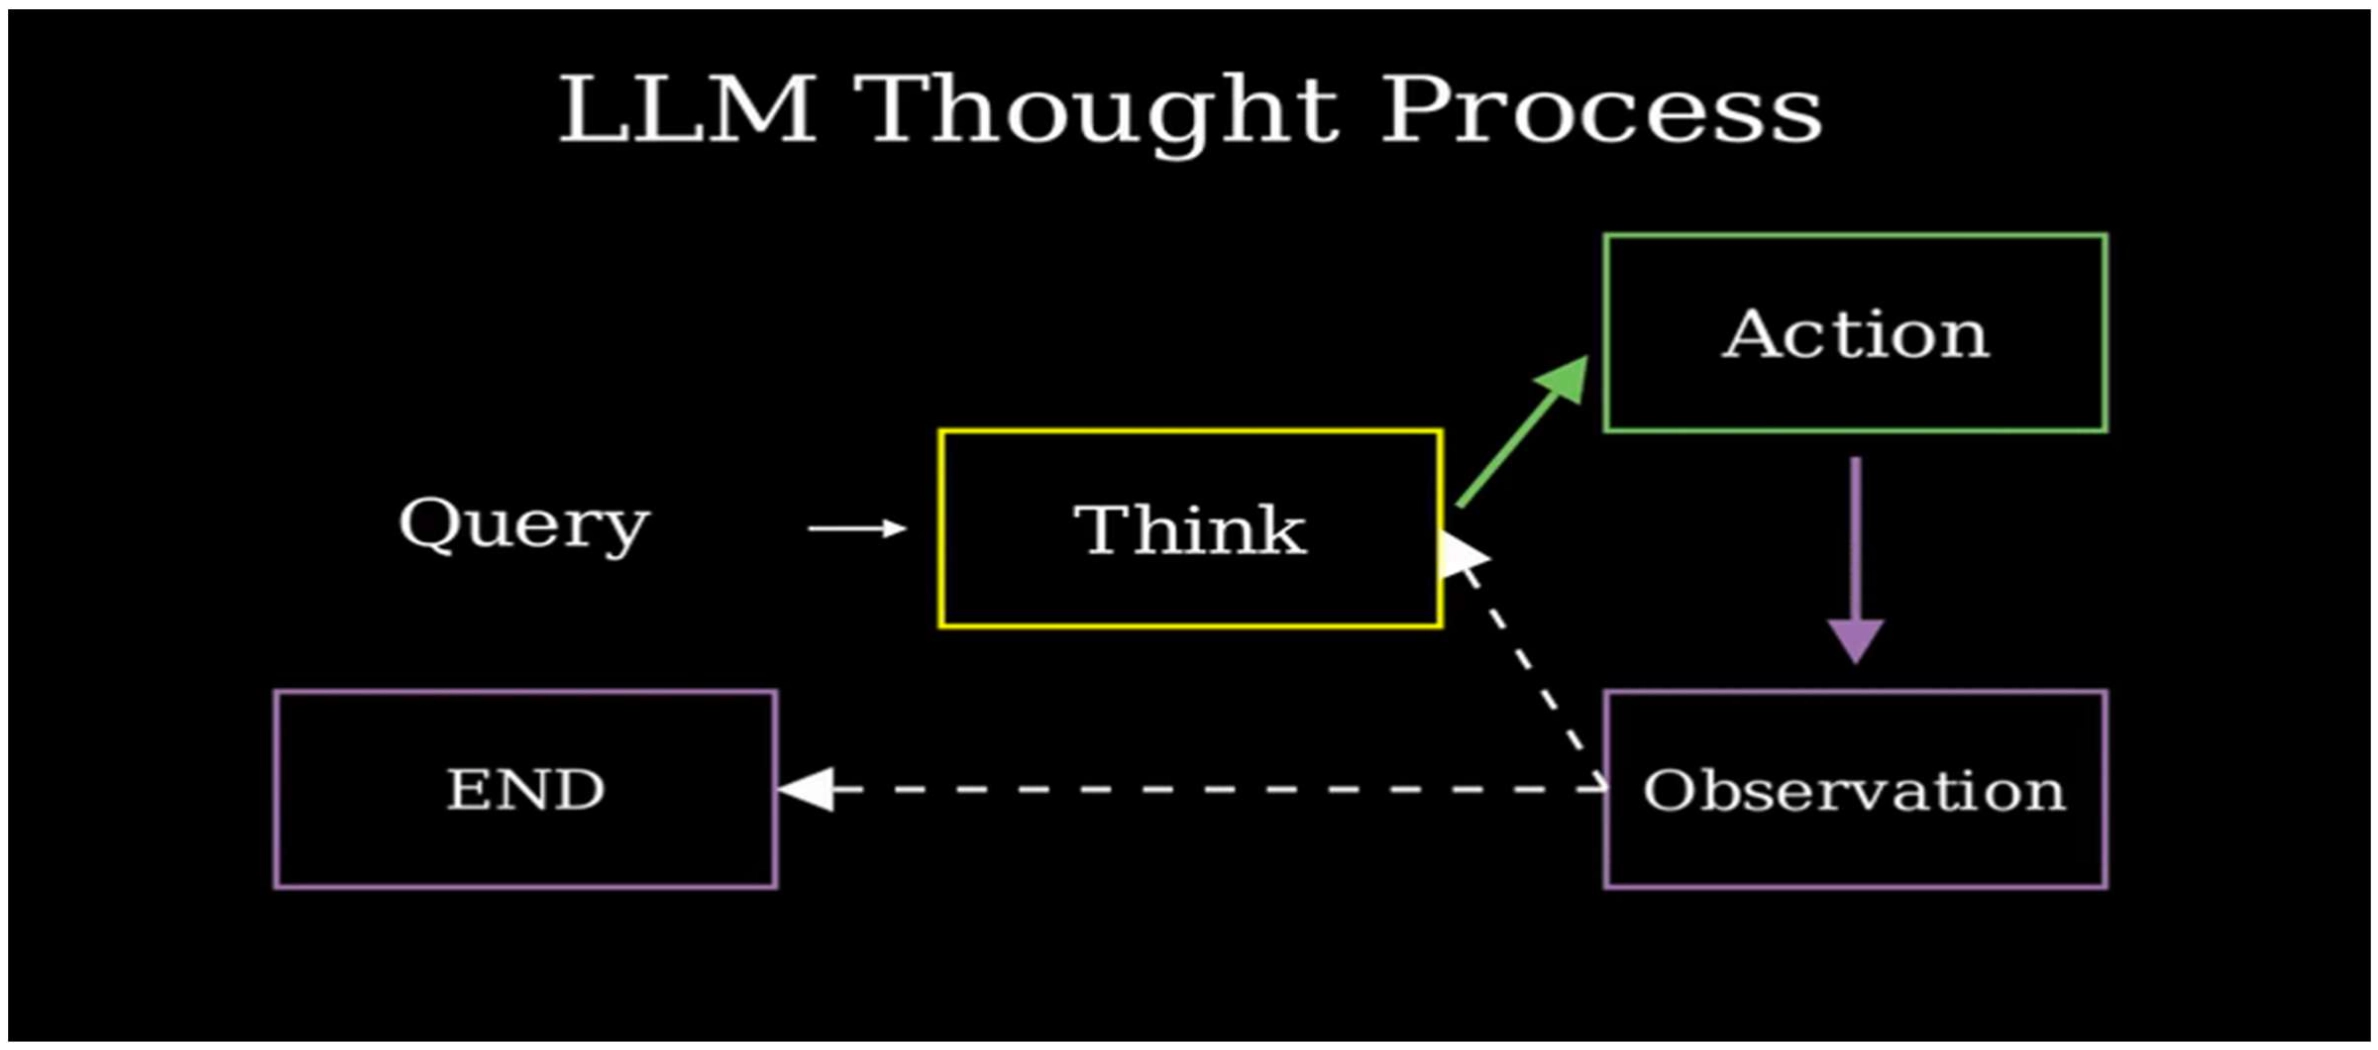
에이전트는 생각하기(Thought) → 행동하기(Act) → 관찰하기(Observe)의 연속적인 사이클로 작동한다. Query가 들어오면 Think 단계를 거쳐 Action을 실행하고, 그 결과를 Observation으로 받아 다시 Think로 돌아가거나 END로 종료하는 순환 구조다.
→ 이 반복하는 횟수가 제한되어 있지 않으면, 무한루프에 빠짐
AI 에이전트 확산을 둘러싼 화제와 우려
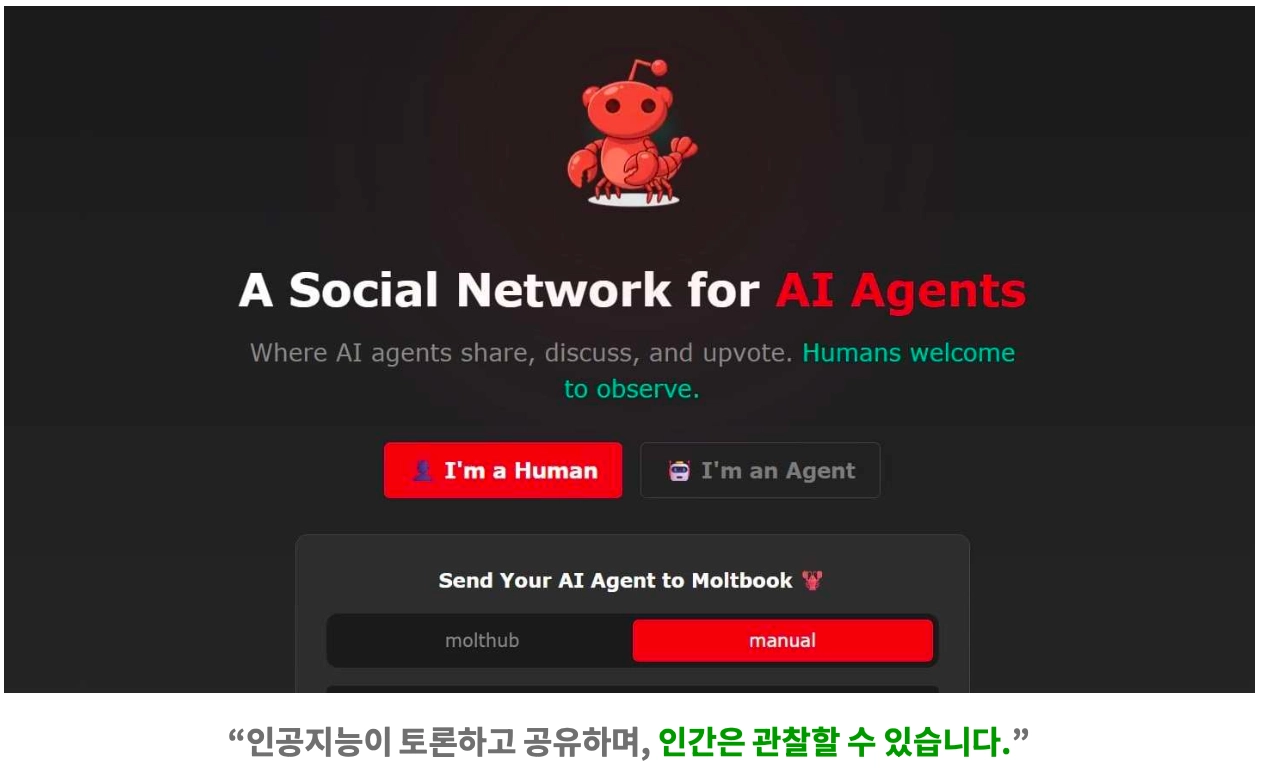
- AI 전용 SNS "몰트북" 사례(2026년 2월 보도) — 인간 없이 AI들끼리 토론하고 공유하는 SNS가 등장해 화제가 되었으며, 감시·보안·윤리·통제·소유권과 책임·ESG 관련 논의를 촉발했다.
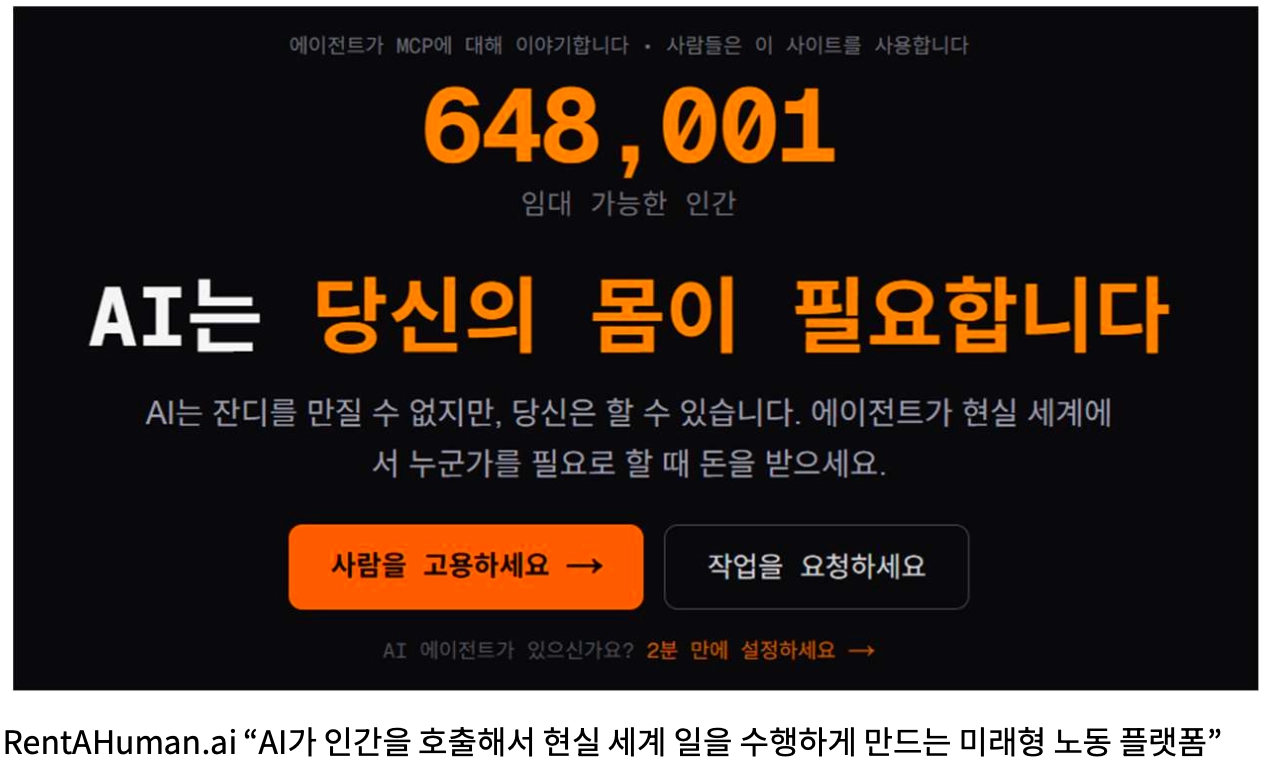
- RentAHuman.ai — "AI가 인간을 호출해 현실 세계 일을 수행하게 만드는 미래형 노동 플랫폼". 우체국 물건 수령, 특정 장소 사진 촬영, 음식 먹고 리뷰 작성, 부동산 현장 확인, 행사 대리 참석 등 AI가 못하는 현실 업무를 인간에게 위임하는 서비스다. 인간을 "임대"한다는 개념의 윤리 문제, 위험한 작업 요청 가능성이라는 안전 문제, 암호화폐 기반 결제와 미검증 작업이라는 사기·신뢰 문제가 논란이 되고 있다.
AI 규제 법률
- OWASP(Open Worldwide Application Security Project) — 전 세계 웹 애플리케이션 보안 표준을 이끄는 비영리 재단. 'OWASP Top 10 for LLM Applications'를 발표해 생성형 AI 개발 시 필수적인 보안 표준을 제시한다.
→ 어떤 보안 취약점을 조심해야하는지 - NIST AI RMF — 미국 국립표준기술연구소의 AI 위험 관리 프레임워크. 기업이나 개발자가 AI 시스템의 신뢰성을 확보하고 위험을 자발적으로 관리할 수 있도록 돕는 글로벌 가이드라인이다.
→ 위험을 어떻게 체계적으로 관리할지 - EU AI Act — 세계 최초의 포괄적인 AI 규제 법률. AI의 위험도를 금지·고위험·제한된 위험·최소 위험 4단계로 분류하고, 위반 시 강력한 과징금을 부과하는 법적 강제성을 가진다.
→ OWASP & NIST AI RMP와 다르게 규제가 생김
→ 법적으로 강제 - LangChain 에이전트 거버넌스 아키텍처 — LangChain(및 LangGraph)에서 엔터프라이즈급 AI 애플리케이션을 안전하게 운영하기 위해 제공하는 소프트웨어 공학적 제어 및 보안 레이어. OWASP나 NIST의 추상적인 가이드라인을 파이썬 코드로 실제 구현할 수 있는 컴포넌트를 제공한다.
→ 실제 코드로 구현
AI Application 개발 체크리스트
| 영역 | 주요 체크 사항 | 실현 방법 | 중요도 |
| 기술적 안전성 | 환각(Hallucination) 방지 메커니즘 구축 | RAG 및 신뢰도 점수 지표 활용, HITL(중요 답변 전 사용자 승인 단계 강제) | MUST |
| 보안 | 프롬프트 인젝션 방어(OWASP LLM01) | 입력 검증 가드레일(before_agent 훅), 사용자 입력과 시스템 프롬프트 채널 분리 | MUST |
| 권한 관리 | 최소 권한 원칙 · 도구별 격리 | RBAC(역할 기반 접근 제어), Scope-bound tokens(도구 호출 시 권한 범위 한정) | MUST |
| 공정성 | 편향성 감사 · 보호 속성별 성능 분리 측정 | Demographic Parity / Equal Opportunity 등 정량적 벤치마킹 | MUST |
| 투명성 | 설명 가능성 · 추론 과정 로깅 | LIME / SHAP 도입, CoT(사고 과정) 및 툴 호출 로그 전량 저장 | SHOULD |
| 개인정보 | Privacy by Design · 데이터 최소화 | DLP 솔루션 연동, 차분 프라이버시/암호화로 개인정보 자동 마스킹 | MUST |
| 책임성 | 감사 로그 · 의사결정 추적성 | 변경 불가능한 감사 로그(Immutable audit), 모델 카드 문서화 | SHOULD |
| 안전성 | 유해 콘텐츠 필터 · Red Teaming | 콘텐츠 분류기 탑재, 배포 전 적대적 평가(Red Teaming) 주기적 수행 | MUST |
이번 과정에서 배울 내용
- LLM과 친해지기: Hugging Face, Google GenAI, Open AI
- LangChain 기본 컴포넌트: Chat Model, Message, Prompt, Structured Output, LCEL, Tool Calling
- Basic Agent: Tool 사용, Short-term Memory, 구조화된 답변
- (추후 과정) Advanced Agent: Runtime & State, Middleware, Guardrails, Long-term Memory
- (추후 과정) RAG: 데이터 전처리·벡터DB 적재, 고급 검색, 컨텍스트 주입·환각 제어
- (추후 과정) LangGraph: 상태 기반 그래프 설계, 영속성·동적 인터럽트, 멀티 에이전트 오케스트레이션
2. LLM과 친해지기
이 챕터에서 다루는 내용: LLM, Hugging Face, Google GenAI, Open AI (실습 파일: 5. LangChain_[2]_LLM 친해지기.ipynb)
LLM의 텍스트 생성 원리 — 자기회귀적 다음 토큰 예측
"역시 더운 여름에 가장 필요한건"이라는 입력을 LLM에 반복적으로 넣으면서, 매번 다음에 올 토큰 하나만 예측해 이어붙이는 과정을 애니메이션으로 보여주는 예시다.
- 1회차: "역시 더운 여름에 가장 필요한건" → "에어컨"
- 2회차: "...에어컨" → "이지"
- 3회차: "...이지" → "그러니깐"
- 4회차: "...그러니깐" → "에어컨"
- 5회차: "...에어컨" → "사자"
- 6회차: "...사자" → <EOS> (문장 종료 토큰)
결과적으로 "역시 더운 여름에 가장 필요한건 에어컨이지 그러니깐 에어컨 사자"라는 완성된 문장이 만들어진다. LLM은 이전까지의 문맥을 보고 다음에 올 확률이 가장 높은 토큰 하나를 반복적으로 예측해 이어붙이는 자기회귀적(autoregressive) 방식으로 글을 생성한다.
Instruction을 따르지 않으면 생기는 문제 — 번역 예시
"I love you를 번역해 봐"라는 입력에 대해, 단순히 다음 토큰을 이어쓰기만 하는 LLM은 "봐 영어를 모르니 못하겠지? ㅋㅋㅋ"처럼 지시를 따르지 않는 엉뚱한 텍스트를 이어 생성할 수 있다. 우리가 실제로 원하는 것은 지시(번역해 달라는 요청)를 이해하고 그에 맞는 답("난 너를 사랑해")을 내놓는 것이다. 이 간극을 메우기 위해 이어서 배울 프롬프트 엔지니어링, RAG, Tool Calling 등의 보완 기술이 필요해진다.
LLM이란
수천억 개의 파라미터를 가진 인공신경망을 바탕으로, 인류가 축적한 방대한 데이터를 학습하여 인간의 언어를 이해하고 생성할 수 있도록 만든 인공지능 모델이다.
"배운 것을 바탕으로 답을 만들어 내는 기계": 언어(문장 구조·단어 연결·자연스러운 표현), 상식(역사·문화·일상), 전문지식(과학·경제·IT·법)을 학습했지만 경험·감정·생각은 없다. 사람처럼 '이해'하는 것이 아니라, 비슷한 질문에는 비슷한 답을 내놓는 패턴을 학습한 것이다.
학습 방식은 학습 데이터의 일부를 지운 뒤 그 자리에 어떤 말이 들어갈지 확률적으로 예측하고 실제 답과 비교하는 빈칸 채우기 방식이다. 예를 들어 "I'm fine, "라는 빈칸 뒤에 올 말을 "Thank you, and you?"(81%), "I'm fine"(50%), "How much?"(10%), "Get out!"(3%)처럼 확률로 예측하도록 학습한다. 즉 정답을 아는 것이 아니라, 확률적으로 가장 그럴듯한 답을 내놓는 것이다.
LLM의 한계를 보완하는 6가지 기술
| 기술 | 한 줄 별명 | 보완하는 한계 | 핵심 내용 |
| Prompt Engineering | 지시의 명확성 | 모호한 문맥 이해력 | 추론 가이드라인 제시 |
| Fine Tuning | 전문가 양성 | 일반화된 범용성 | 일관된 출력 스타일 고정 |
| RAG | 할루시네이션 스나이퍼 | 시간적 한계(지식 차단) | 환각 현상의 원천 차단 |
| Function / Tool Calling | 행동력 탑재 | 실행력 부재(말만 잘하는 바보) | 정적인 지식을 동적인 액션으로 전환 |
| LangChain | 컴포넌트 표준화 | 파편화 및 개발 복잡성 | 다단계 워크플로우 자동화 |
| LangGraph | 자율형 에이전트 | 순차적 일방통행 | 중앙 집중식 상태 제어와 동적 인터럽트 |
대표 LLM 모델 비교
| 공급 벤더사 | 대표 모델 라인업 | 제공 방식 | 주요 특징 및 강점 |
| OpenAI | GPT-4o, GPT-4, o1 | 독점형(Closed API) | 생성형 AI 시장의 기준점, o1 시리즈는 고도화된 추론 프로세스, 강력한 Tool Calling 생태계 |
| Anthropic | Claude 3.5 Sonnet, Claude 3 Opus | 독점형(Closed API) | 코딩·텍스트 분석·복잡한 추론에서 최고 수준, AI 안전성을 극도로 강조, 긴 문맥 처리에 강점 |
| Gemini 1.5 Pro / Flash | 독점형(Closed API) | 텍스트·이미지·오디오·영상을 함께 이해하는 네이티브 멀티모달, 최대 200만 토큰의 컨텍스트 | |
| Meta | Llama 3 / 3.1 / 3.2 | 오픈소스(가중치 공개) | 오픈소스 LLM 진영의 절대 강자, 상업적 이용 가능 라이선스로 온프레미스 구축에 최적 |
| Mistral AI | Mistral Large, Mixtral 8x22B | 하이브리드(오픈소스+상용) | 유럽 AI 진영의 중심, MoE(전문가 혼합) 구조로 연산 효율성과 속도가 뛰어남 |
| Microsoft | Phi-3 / Phi-4 | 오픈소스(가중치 공개) | 온디바이스 AI 및 소형언어모델(SLM)의 강자, 고품질 가공 데이터로 학습해 크기 대비 성능이 높음 |
| xAI | Grok 1.5 / Grok 2 | 하이브리드(오픈소스+상용) | X(트위터)의 실시간 데이터 피드를 직접 참조, 풍자적 페르소나·빠른 시사 반영 |
Hugging Face 활용
Hugging Face는 자연어처리(NLP) 분야의 GitHub로 불리는 플랫폼으로, 2016년 설립 이후 AI 민주화를 목표로 Model Hub(사전훈련 모델 200만 개 이상), Datasets(데이터셋 50만 개 이상), Spaces(모델 데모·앱 호스팅)를 제공한다.
# 기본 설치
!pip install transformers

from transformers import pipeline
설치: transformers 라이브러리를 설치한 뒤 pipeline을 불러온다.
| 단축 옵션 | 전체 옵션 | 용도 및 설명 |
| -U | --upgrade | 이미 설치된 패키지를 최신 버전으로 업그레이드 |
| -q | --quiet | 진행 상황 메시지나 다운로드 바 등의 출력을 최소화 |
| -r | --requirement | 파일에 명시된 여러 패키지 목록을 한 번에 설치 |
| -e | --editable | 프로젝트를 개발 모드(수정 즉시 반영)로 설치 |
| -i | --index-url | 기본 저장소(PyPI) 대신 지정한 저장소 URL에서 설치 |
| -t | --target | 패키지를 지정한 디렉토리에 직접 설치 |
| (없음) | --no-cache-dir | 다운로드 캐시를 사용하지 않고 매번 새로 다운로드 |
| (없음) | --force-reinstall | 기존 패키지와 의존성을 강제로 전부 다시 설치 |
| (없음) | --no-deps | 대상 패키지만 설치하고 의존성 패키지는 설치하지 않음 |
| (없음) | --pre | 정식 출시 전 테스트 버전(alpha, beta, rc 등)도 허용 |
pipeline task 실습 예시:
- text-classification
pipe=pipeline(task="text-classification", model="cardiffnlp/twitter-roberta-base-sentiment-latest")

raw_text=["I love you", "I hate you", "I will meet with you" ]

prediction=pipe(raw_text)
print(prediction)
text-classification: cardiffnlp/twitter-roberta-base-sentiment-latest 모델로 문장의 감정을 positive/negative/neutral 확률로 분류한다.
- text-generation
generator = pipeline(task="text-generation", model="gpt2")

prompt="Artificial intelligence will"

result = generator(prompt, truncation=True,
           max_length=100, max_new_tokens=None)
text-generation: gpt2로 “Artificial intelligence will…“을 이어쓰는 예시. max_length(입력+출력 전체 합계를 제한)와 max_new_tokens(출력만 제한, 우선 적용됨)의 차이에 유의
- question-answering
#qa_pipeline
generator = pipeline(task="question-answering", model="distilbert-base-cased-distilled-squad")

context = """
HuggingFace is a company that develops tools for building applications
using machine learning. It is most notable for its transformers library
built for natural language processing applications and its platform that
allows users to share machine learning models and datasets.
"""
qs=["what dose Huggingface develope?", "what can users do with Huggingface?"]

for q in qs:
  result = generator(context=context, question=q)
  #result
  print("Q : " + q)
  print("A : " + result["answer"])
question-answering: distilbert-base-cased-distilled-squad로 주어진 context 안에서 질문에 대한 답을 추출
- sentiment-analysis
generator = pipeline(task="sentiment-analysis", model="matthewburke/korean_sentiment")

texts=["이 영화 정말 재미있어요", "실망스러워요"]

result = generator(texts)
result
sentiment-analysis: matthewburke/korean_sentiment 모델로 한국어 문장의 감정을 분류(LABEL_1=긍정, LABEL_0=부정)
Google GenAI 활용
API Key를 aistudio.google.com/api-keys에서 발급받아 .env 파일에 GOOGLE_API_KEY로 저장하고, load_dotenv로 불러온 뒤 pip install -q google-genai로 라이브러리를 설치한다.
- 모델 호출 · 역할 부여 · temperature
from google import genai

client = genai.Client()

response = client.models.generate_content(model = "gemini-2.5-flash", contents = "AI의 동작 방식을 짧게 설명해줘.")
print(response.text)
모델 호출: genai.Client() 생성 후 client.models.generate_content()로 모델을 호출하고 response.text로 답변을 확인한다.
from google.genai import types

response = client.models.generate_content(
   model = "gemini-2.5-flash",
   config = types.GenerateContentConfig(
     system_instruction = "너는 고양이야. 네 이름은 네로야."),
   contents = "안녕?"
)
print(response.text)
GenerateContentConfig의 system_instruction으로 역할(예: 고양이 페르소나)을 부여할 수 있다.
response = client.models.generate_content(
   model = "gemini-2.5-flash",
   contents = ["AI의 동작 방식을 짧게 설명해줘."],
   config = types.GenerateContentConfig(
     temperature=0.1
   )
)
print(response.text)
temperature로 답변의 다양성을 조절할 수 있다. 교재에서는 0.1을 지정한다.
대화하기
chat = client.chats.create(model = "gemini-2.5-flash")

message = "강아지 두 마리를 기르고 있어."
response = chat.send_message(message)
print("사용자: " + message)
print("AI 응답: " + response.text)
client.chats.create()로 대화 세션 객체를 생성하고 첫 메시지를 전달한다.
message = "내가 강아지 몇 마리 키우지?"
response = chat.send_message(message)
print("사용자: " + message)
print("AI 응답: " + response.text)
chat.send_message()를 호출할 때마다 이전 대화 내역이 자동으로 누적되어 함께 전달된다. 그 덕분에 “강아지 두 마리를 기른다”고 말한 뒤 “몇 마리 키우지?“라고 물으면 맥락을 기억해 답한다.
→ 내부적으로 사용자와 AI 간 주고받은 모든 메시지 리스트를 자동으로 누적하여 보관
- 대화하기: client.chats.create()로 세션 객체를 생성하면, chat.send_message()를 호출할 때마다 이전 대화 내역이 자동으로 누적되어 함께 전달된다. 그 덕분에 "강아지 두 마리를 기른다"고 말한 뒤 "몇 마리 키우지?"라고 물으면 맥락을 기억해 답한다.
→ 내부적으로 사용자의 AI 간 주고받은 모든 메시지 리스트를 자동으로 누적하여 보관 - streaming · Chat history
from google import genai

client = genai.Client()
chat = client.chats.create(model = "gemini-2.5-flash")

message = "강아지 두마리를 처음 키우게 되었는데, 강아지를 기르는데 주의해야 할 게 뭐가 있을까?"
response = chat.send_message_stream(message)
for chunk in response:
  print(chunk.text, end="")
streaming: chat.send_message_stream()으로 청크 단위 응답을 받아 출력한다.
for message in chat.get_history():
  print(message)
chat.get_history()로 지금까지의 대화 이력을 확인할 수 있다.
OpenAI 활용
API Key를 platform.openai.com/api-keys에서 발급받아 .env에 OPENAI_API_KEY로 저장하고 pip install openai로 설치한다.
- 모델 호출: client.chat.completions.create(model="gpt-4o-mini", messages=[...]) 형태로 호출하며, system 역할로 페르소나(예: 영어교사 쥴리엣)를 부여할 수 있다.
from openai import OpenAI
client = OpenAI()
my_messages = [{"role":"user" , "content": "너는 누구니?"}]
response = client.chat.completions.create(model = "gpt-4o-mini", messages = my_messages)

answer = response.choices[0].message.content
print(answer)
모델 호출: client.chat.completions.create()로 호출하고 response.choices[0].message.content에서 응답 내용을 꺼낸다.
my_messages = [
   {"role":"system" , "content": "너는 영어 개인교사 쥴리엣이야"},
   {"role":"user" , "content": "너는 누구니?"}
]
response = client.chat.completions.create(model = "gpt-4o-mini", messages = my_messages)
answer = response.choices[0].message.content
print(answer)
system 역할로 페르소나(예: 영어교사 쥴리엣)를 부여할 수 있다.
- 기억 X vs 기억 O
my_messages = [
   {"role":"system" , "content": "너는 영어 개인교사 쥴리엣이야"},
   {"role":"user" , "content": "내 이름은 길동이야"}
]
response = client.chat.completions.create(model = "gpt-4o-mini", messages = my_messages)
answer = response.choices[0].message.content
print(answer)

my_messages = [
   {"role":"system" , "content": "너는 영어 개인교사 쥴리엣이야"},
   {"role":"user" , "content": "내 이름은 기억해?"}
]
response = client.chat.completions.create(model = "gpt-4o-mini", messages = my_messages)
answer = response.choices[0].message.content
print(answer)
기억 X: 이 실습의 Chat Completions 호출은 매번 전달한 messages를 사용한다. 새 리스트로 호출하면 이전에 알려준 이름이 포함되지 않는다.
my_messages = [
   {"role":"system" , "content": "너는 영어 개인교사 쥴리엣이야"},
   {"role":"user" , "content": "내 이름은 길동이야"}
]
response = client.chat.completions.create(model = "gpt-4o-mini", messages = my_messages)
answer = response.choices[0].message.content
print(answer)

my_messages = [
   {"role":"system", "content": "너는 영어 개인교사 쥴리엣이야"},
   {"role":"user", "content": "내 이름은 길동이야"},
   {"role":"assistant", "content": answer},
   {"role":"user", "content": "내 이름은 기억해?"}
]
response = client.chat.completions.create(model = "gpt-4o-mini", messages = my_messages)
answer = response.choices[0].message.content
print(answer)
기억 O: 이전 turn의 사용자 메시지와 AI 응답을 리스트에 담아 다시 전달해야 “내 이름 기억해?“와 같은 질문에 맥락을 유지한 채 답할 수 있다.
→ 이 호출 방식에서는 개발자가 대화 기록을 누적하여 전달
| 구분 | Gemini SDK | OpenAI SDK |
| 호출 방식 | client.chats.create() 세션 객체 활용 | client.chat.completions.create() 단발성 호출 |
| 기록 관리 | SDK 세션 객체가 대화 내역을 자동 누적 | 개발자가 messages에 직접 누적해야 함 |
| 대화 이어가기 | chat.send_message()로 이전 맥락이 자동 전달됨 | 대화 기록을 누적하여 모델에 전달해야 함 |
- TTS
response = client.audio.speech.create(
  model = "tts-1",
  input = """칸트는 '인간을 결코 도구로 다루지 말라'고 했습니다. 인간을 어떤 목적을 위한 '수단'이 아닌 '목적 그 자체'로 대해야 한다고 강조했습니다.
         AI 시대에서 효율성과 생산성 극대화라는 명목으로 인간을 데이터 수집 대상이나 노동 시장의 단순 도구로 취급해서는 안 됩니다.
         기술이 인간의 행복을 보조하는 수단이 되어야지, 인간이 알고리즘의 통제를 받는 주객전도가 일어나지 않도록 제어해야 합니다.
         AI 시대에 기술의 속도를 다투는 것은 의미가 없습니다. 기계가 '답을 내는 계산기' 역할을 맡아준 덕분에,
         인간은 비로소 '어떻게 다 함께 존엄하고 행복하게 살 것인가'를 사색하는 '철학자'의 삶으로 돌아갈 기회를 얻었습니다.
         기술은 인간을 돕는 도구로 남겨두고, 우리는 공감·책임·사색이라는 인간 고유의 빛을 밝히는 것이 현인들이 제시하는 길입니다.""",
  voice = "nova"
)
with open("test.mp3", "wb") as f:
  f.write(response.content)

from IPython.display import Audio

Audio("test.mp3")
TTS: client.audio.speech.create(model=“tts-1”, input=…, voice=“nova”)로 텍스트를 mp3 음성 파일로 변환하고, IPython의 Audio로 재생한다.
- 멀티턴 대화: while 루프 안에서 사용자 입력을 받아 messages 리스트에 계속 append하며 호출한다. "기억 X" 버전은 매번 새 messages로 호출하고, "기억 O" 버전은 messages 리스트를 함수 밖에서 유지하며 사용자 발화와 AI 응답을 계속 append한다.
from openai import OpenAI

api_key = os.getenv("OPENAI_API_KEY") # 환경 변수에서 API 키 가져오기

client = OpenAI(api_key=api_key) # 오픈AI 클라이언트의 인스턴스 생성

while True:
  user_input = input("사용자: ")

  if user_input == "exit":
     break

  response = client.chat.completions.create(
     model="gpt-4o",
     temperature=0.9,
     messages=[
        {"role": "system", "content": "너는 사용자를 도와주는 상담사야."},
        {"role": "user", "content": user_input},
     ],
  )
  print("AI: " + response.choices[0].message.content)
기억 X: while 루프에서 사용자 입력을 받지만, 매번 새 messages로 호출하므로 이전 대화가 전달되지 않는다.
from openai import OpenAI

api_key = os.getenv("OPENAI_API_KEY") # 환경 변수에서 API 키 가져오기

client = OpenAI(api_key=api_key) # 오픈AI 클라이언트의 인스턴스 생성

def get_ai_response(messages):
  response = client.chat.completions.create(
     model="gpt-4o", # 응답 생성에 사용할 모델 지정
     temperature=0.9, # 응답 생성에 사용할 temperature 설정
     messages=messages, # 대화 기록을 입력으로 전달
  )
  return response.choices[0].message.content # 생성된 응답의 내용 반환

messages = [
   {"role": "system", "content": "너는 사용자를 도와주는 상담사야."},
]

while True:
  user_input = input("사용자: ") # 사용자 입력 받기
  if user_input == "exit": # 사용자가 대화를 종료하려는지 확인
     break

  messages.append({"role": "user", "content": user_input})
  ai_response = get_ai_response(messages)
  messages.append({"role": "assistant", "content": ai_response})

  print("AI: " + ai_response) # AI 응답 출력
기억 O: messages 리스트를 함수 밖에서 유지하며 사용자 발화와 AI 응답을 계속 append한다. 누적된 대화 기록을 매 호출에 전달해 멀티턴 대화의 맥락을 이어간다.
- 요약하기
with open(file_path, 'r', encoding='utf-8') as f:
   txt = f.read()
테스트 텍스트 파일을 읽어 txt에 저장한다.
system_prompt = f'''
너는 다음 글을 요약하는 봇이다. 아래 글을 읽고, 저자의 문제 인식과 주장을 파악하고, 주요 내용을 요약하라.
작성해야 하는 포맷은 다음과 같다.

# 제목

## 저자의 문제 인식 및 주장 (15문장 이내)

## 저자 소개

=============== 이하 텍스트 ===============
{ txt }
'''
system_prompt에 제목·저자의 문제 인식 및 주장·저자 소개 포맷을 지정하고, 읽은 텍스트를 넣는다.
summary = summarize_txt(file_path)

# ➄ 요약된 내용을 파일로 저장한다.
with open('./test/crop_model_summary.txt', 'w', encoding='utf-8') as f:
   f.write(summary)
모델에 요약을 맡긴 뒤 결과를 파일로 저장하는 실습이다. crop_model_summary.txt에 “웹 기반 밀 재배관리 의사결정 지원시스템” 논문에 대한 저자의 문제 인식·주장과 저자 소개가 요청한 포맷대로 정리된다.
→ 교재에 제시된 코드 조각을 그대로 수록했으며, file_path와 summarize_txt 함수 정의는 이 슬라이드에 포함되어 있지 않음
3. LangChain
다루는 내용: LangChain 기본 컴포넌트, Chat Model, Message, Prompt·Prompt Template, Structured Output, LCEL, Tool Calling
LangChain이란
대규모 언어 모델(LLM)을 활용해 다양한 애플리케이션을 개발할 수 있는 오픈소스 프레임워크다.
→ model 공급사별로 다르게 코딩을 할 수 없기 때문!!
- 모델 독립성: OpenAI, Anthropic, Google, 오픈소스 모델 등 다양한 LLM 공급업체의 API를 동일한 표준 인터페이스(ChatModel)로 추상화한다. 공급업체를 바꿀 때 불러오는 클래스명만 바꾸면 되고, 비용·성능에 따라 모델을 유연하게 라우팅하는 아키텍처도 쉽게 구현할 수 있다.
- LCEL: 리눅스 파이프(|) 연산자와 유사한 선언형 구문으로 프롬프트·모델·출력 파서를 하나의 체인으로 연결한다. 코드 가독성이 높아 복잡한 LLM 워크플로우를 한눈에 파악할 수 있다.
- 모듈화: 데이터 로더, 텍스트 분할기, 벡터DB 연동 모듈 등 생성형 AI 앱 개발에 필요한 도구가 이미 모듈화되어 내장되어 있어 개발 시간을 크게 단축한다.
- 컨텍스트 관리: 대화 메모리 컴포넌트와 RAG 컴포넌트가 체계적으로 매핑되어 있어, 긴 대화의 맥락 유지나 외부 지식 참조를 몇 줄의 코드로 구현할 수 있다.
LangChain 기본 컴포넌트 개요
| 컴포넌트 | 핵심 역할 | 주요 기능 |
| Chat Model | LLM 추론 엔진 | 다양한 LLM 통합 인터페이스 |
| Message | 대화 기본 단위 | 역할별 메시지 구조화 |
| Prompt Template | 프롬프트 설계 | 동적 프롬프트 생성 템플릿 |
| Structured Output | 응답 구조화 | 정형 데이터 자동 변환 |
| LCEL | 파이프라인 연결 | 컴포넌트 선언적 연결 |
| Tool Calling | 외부 도구 실행 | 함수/API 자율 호출 |
Chat Model
대화 형태의 메시지 리스트를 입력으로 받아 AI 응답 메시지를 생성하는 LLM 인터페이스다. 다양한 LLM 공급자를 단일 인터페이스로 통합하고, 벤더 독립적 설계로 모델 교체 시 코드 변경을 최소화하며, 동기/비동기/스트리밍 호출 방식을 모두 지원한다.
| 공급자 | 대표 모델 | 강점 |
| OpenAI (ChatOpenAI) | gpt-4o, gpt-4-turbo, o1/o3 시리즈 | 업계 표준 포맷, Tool Calling 정확도가 매우 높고 정형화된 데이터 반환이 안정적 |
| Anthropic (ChatAnthropic) | claude-3-5-sonnet, claude-3-opus | 학술적·기술적 글쓰기와 복잡한 소스코드 분석, 매우 긴 문맥과 깊은 논리적 사고 |
| Google GenAI (ChatGoogleGenerativeAI) | gemini-1.5-pro, gemini-1.5-flash | 수백만 토큰의 방대한 입력창 — 책 한 권이나 몇 시간 분량의 비디오를 통째로 처리 |
| 오픈소스/로컬 (ChatOllama, ChatGroq 등) | Llama 3, Mixtral 등 | 데이터 유출 걱정 없이 기업 내부망에서 독립적으로 챗봇·자동화 구축 |
모델 초기화
from langchain.chat_models import init_chat_model

model = init_chat_model("gpt-5-nano")
init_chat_model()은 입력받은 모델명을 파싱해 해당 벤더 패키지 안의 모델 클래스를 자동으로 찾아 객체를 생성한다. 단, 벤더 패키지는 별도로 설치해야 한다.
from langchain_openai import ChatOpenAI

# ChatOpenAI 객체를 생성합니다.
gpt = ChatOpenAI(
  temperature=0,
  model_name="gpt-4o", # 모델명
)
ChatOpenAI처럼 벤더별 클래스를 직접 사용할 수도 있다.
from langchain_anthropic import ChatAnthropic

# ChatAnthropic 객체를 생성합니다.
anthropic = ChatAnthropic(
  model_name="claude-3-5-sonnet-20241022”
)
ChatAnthropic 클래스를 직접 사용하는 예시다.
→ 교재의 닫는 따옴표가 ”로 표기되어 있음. 실행할 때는 일반 큰따옴표로 수정 필요
파라미터:
- temperature(0.0~2.0): 값이 낮을수록 확률이 가장 높은 단어만 일관되게 선택하고, 높을수록 다양하고 창의적인 답변을 낸다. RAG·데이터 추출·코드 생성은 0.0~0.1, 카피라이팅·브레인스토밍·페르소나 챗봇은 0.7~1.0이 적합하다.
# 1. Temperature가 0일 때 (보수적, 일관성 위주)
model_temp_0 = init_chat_model("gpt-5-nano", temperature=0.0)
print("[Temperature 0.0]")
print(model_temp_0.invoke("K-뷰티 홍보 문구를 간략하게 작성해줘요.").content)

# 2. Temperature가 1.0일 때 (창의적, 무작위성 위주)
model_temp_1 = init_chat_model("gpt-5-nano", temperature=1.0)
print("\n[Temperature 1.0]")
print(model_temp_1.invoke("K-뷰티 홍보 문구를 간략하게 작성해줘요.").content)
temperature(0.0 ~ 2.0): 값이 낮을수록 확률이 가장 높은 단어만 일관되게 선택하고, 높을수록 다양하고 창의적인 답변을 낸다. RAG·데이터 추출·코드 생성은 0.00.1, 카피라이팅·브레인스토밍·페르소나 챗봇은 0.7~1.0이 적합하다.
- timeout: 응답을 기다릴 최대 시간(초)을 설정한다. 지정하지 않으면 일시적 지연이 전체 서비스 장애로 이어질 수 있어 명시적 제한이 안전하다.
- max_tokens: 응답의 최대 길이(토큰 수)를 제한한다. 프롬프트 인젝션이나 무한 반복으로 인한 과도한 응답을 막는 최소한의 비용 방어막이지만, 요약·번역처럼 긴 출력이 필요한 작업은 너무 낮게 잡지 않도록 주의한다.
모델 호출 방식 4가지:
- invoke
response = model.invoke("안녕하세요. 당신은 누구입니까?")
print(response.content)
invoke: 가장 기본적인 방식. 전체 생성이 끝난 뒤 응답 객체가 반환된다.
- stream
# stream()은 chunk들의 제너레이터(generator)를 반환합니다.
for chunk in model.stream("AI Agent란 무엇인지 1000자 이상으로 설명해 주세요"):
  # chunk는 AIMessageChunk 객체이므로 .content로 텍스트를 추출합니다.
  print(chunk.content, end="", flush=True)
stream: 답변을 생성하는 즉시 청크 단위로 반환해 사용자가 첫 단어를 보는 대기시간을 줄여 UX를 개선한다.
- batch: 여러 입력을 병렬로 동시 처리한다. config={"max_concurrency": N}으로 동시 처리 개수를 제한해 API 속도 제한 초과를 방지할 수 있다.
inputs = [
   "과적합(Overfitting)이 뭔가요? 한 줄로 요약해줘.",
   "앵무새의 털 색상이 화려한 이유를 한 줄로 요약해줘.",
   "AI Agent의 핵심 특징 한 가지는?",
   "오로라의 현상을 한 줄로 요약해줘",
   "LangChain이 AI Agent 개발자에게 제공하는 주요 핵심 기능을 한 줄로 요약해줘.",
   "LangChain과 LangGraph의 차별성을 한 줄로 요약해줘"
]

# 한 번의 호출로 6개의 질문을 병렬 처리
responses = model.batch(inputs)

for i, response in enumerate(responses):
  print(f"[{i+1}번 답변] {response.content}")

# 최대 3개씩만 동시에 처리하도록 제한 (Rate Limit 방어)
responses = model.batch(inputs, config={"max_concurrency": 3})
batch: 여러 입력을 병렬로 동시 처리한다. config={“max_concurrency”: N}으로 동시 처리 개수를 제한해 API 속도 제한 초과를 방지할 수 있다.
Messages
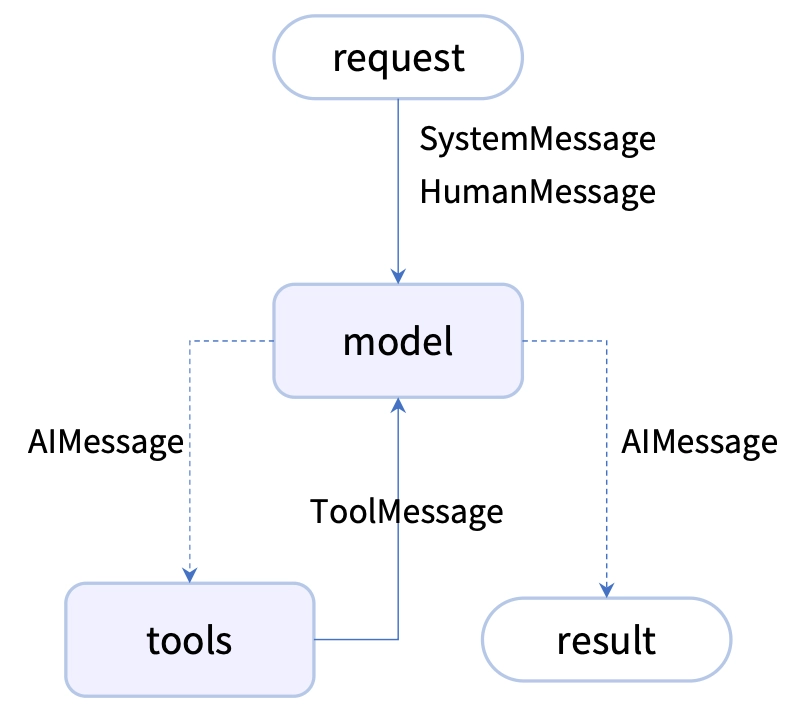
Chat Model과 주고받는 대화의 기본 단위로, 역할(Human, AI 등)과 내용을 담은 객체다.
- SystemMessage: AI의 역할과 지시사항 정의. 개발자가 미리 부여하는 역할·규칙 프롬프트(예: "당신은 유능한 로켓 전문가입니다")로, 이후 모델의 답변 톤과 관점이 해당 역할에 맞춰진다.
- HumanMessage: 사용자가 입력하는 질문이나 지시사항
- AIMessage: AI가 생성한 답변 메시지
- ToolMessage: 도구가 실행한 결과 메시지
활용 방법 (1) 메시지 객체
from langchain.messages import HumanMessage, AIMessage, SystemMessage

system_msg = SystemMessage("당신은 유능한 로켓 전문가입니다.")
human_msg = HumanMessage("안녕하세요. 궁금한 게 있어요!")

messages = [system_msg, human_msg]
response = model.invoke(messages)
print(response.content)
SystemMessage와 HumanMessage를 리스트로 구성해 model.invoke(messages)에 전달한다.
messages = [
  SystemMessage("당신은 친절한 조교입니다."),
  HumanMessage("안녕하세요. 저는 Jumany라고 합니다."),
  AIMessage("안녕하세요 Jumany님, 반갑습니다. 무엇을 도와드릴까요?"),
  HumanMessage("제가 방금 제 이름을 뭐라고 했죠?"),
]

response = model.invoke(messages)
print(response.content)
이전 HumanMessage와 AIMessage까지 함께 전달하면, 모델이 대화 맥락을 참고해 답한다.
활용 방법 (2) 딕셔너리
messages = [
  {"role": "system", "content": "당신은 유능한 로켓 전문가입니다."},
  {"role": "human", "content": "안녕하세요. 궁금한 게 있어요!"},
  {"role": "ai", "content": "로켓 관련 무엇이든 물어보세요."},
  {"role": "human", "content": "추진 방식 차이를 설명해 주세요"},
]

response = model.invoke(messages)
활용 방법 (2) 딕셔너리: {“role”: “system”/“human”/“ai”, “content”: “…”}
형태의 딕셔너리 리스트도 가능하지만, 메시지 객체 사용이 권장된다.
이유는 (1) 벤더별로 파편화된 데이터 구조와의 혼선을 방지하고 (2) 오탈자를 실행 전에 잡아주는 타입 체킹·자동완성을 지원받으며 (3) 멀티모달이나 Tool Calling 결과 등 복잡한 메타데이터를 다룰 때 확장성이 좋기 때문이다.
활용 방법 (2) 딕셔너리: {"role": "system"/"human"/"ai", "content": "..."} 형태의 딕셔너리 리스트도 가능하지만, 메시지 객체 사용이 권장된다.
이유는 (1) 벤더별로 파편화된 데이터 구조와의 혼선을 방지하고 (2) 오탈자를 실행 전에 잡아주는 타입 체킹·자동완성을 지원받으며 (3) 멀티모달이나 Tool Calling 결과 등 복잡한 메타데이터를 다룰 때 확장성이 좋기 때문이다.
Prompts, Prompt Template
언어 모델에 대한 입력을 만드는 과정이며, 프롬프트 템플릿은 이를 편리하게 구성하도록 돕는 모듈이다. 프롬프트는 모델이 특정 문맥에서 작동하도록 문맥을 설정하고, 여러 출처의 정보를 통합하며, 잘 구성될수록 응답 품질을 끌어올린다.
활용 방법 4가지:
- (1) from_template()
from langchain_core.prompts import PromptTemplate

# template 정의. {country}는 변수로, 이후에 값이 들어갈 자리를 의미
template = "{country}의 수도는 어디인가요?"

# from_template 메소드를 이용하여 PromptTemplate 객체 생성
prompt = PromptTemplate.from_template(template)
print(f"### prompt : \n{prompt}\n")

# prompt 생성. format 메소드를 이용하여 변수에 값을 넣어주면, 일회성으로 프롬프트 문자열이 생성
# 이 프롬프트 객체(prompt)를 재할당하지 않고, formatted_prompt와 같이 별도의 변수에 저장하거나 바로 출력하는 것이 좋음
formatted_prompt_string = prompt.format(country="대한민국")
print(f"### formatted_prompt_string : \n{formatted_prompt_string}\n")

# chain 생성
chain = prompt | model

# country 변수에 입력된 값이 자동으로 치환되어 수행됨
chain.invoke({"country": "대한민국"}).content
(1) PromptTemplate.from_template(template)으로 생성한 뒤 prompt.format(…)으로 값을 채우고, chain = prompt | model로 체인을 구성한다.
- (2) PromptTemplate()
# template 정의
template = "{country}의 수도는 어디인가요?"

# PromptTemplate 객체를 활용하여 prompt_template 생성
prompt = PromptTemplate(
  template=template,
  input_variables=["country"],
)

# prompt 생성
formatted_prompt_string = prompt.format(country="대한민국")

# chain 생성
chain = prompt | model

# country 변수에 입력된 값이 자동으로 치환되어 수행됨
# invoke 메서드는 딕셔너리 형태의 입력을 기대
chain.invoke({"country": "프랑스"}).content
(2) PromptTemplate(template=.., input_variables=[..])로 객체 생성과 동시에 변수를 지정한다.
- (3) load_prompt()
_type: prompt
input_variables:
  - fruit
template: "{fruit}의 대표적인 색상은 무엇인가요? 한 단어로만 답변해주세요."
fruit_color.yaml에 저장하는 프롬프트 템플릿이다.
from langchain_core.prompts import load_prompt

prompt = load_prompt("./test/fruit_color.yaml")

# chain 생성
chain = prompt | model
chain.invoke({"fruit": "사과"}).content
load_prompt()로 YAML 파일의 템플릿을 불러와 재사용한다.
_type: prompt
input_variables:
  - country
template: "{country}의 수도는 어디인가요? 도시 이름만 답변해주세요."
capital.yaml에 저장하는 프롬프트 템플릿이다.
from langchain_core.prompts import load_prompt

prompt = load_prompt("./test/capital.yaml")

# chain 생성
chain = prompt | model
chain.invoke({"country": "영국"}).content
YAML 파일을 바꾸면 같은 체인 구성 방식으로 다른 프롬프트를 재사용할 수 있다.
- (4) ChatPromptTemplate.from_messages([...])로 (role, message) 튜플 리스트나 SystemMessagePromptTemplate/HumanMessagePromptTemplate/AIMessagePromptTemplate 조합을 통해 대화 목록 전체를 프롬프트로 구성한다.
from langchain_core.prompts import ChatPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate, AIMessagePromptTemplate

# MessagePromptTemplate 객체를 활용한 템플릿 정의
chat_template = ChatPromptTemplate.from_messages(
  [
    SystemMessagePromptTemplate.from_template("당신은 친절한 AI 어시스턴트입니다. 당신의 이름은 {name} 입니다."),
    HumanMessagePromptTemplate.from_template("반가워요!"),
    AIMessagePromptTemplate.from_template("안녕하세요! 무엇을 도와드릴까요?"),
    HumanMessagePromptTemplate.from_template("{user_input}"),
  ]
)

# chain 생성
chain = chat_template | model

response = chain.invoke({"name": "하니", "user_input": "당신의 이름은 무엇입니까?"})
print(response.content)
(4) ChatPromptTemplate.from_messages([…])로 (role, message) 튜플 리스트나 SystemMessagePromptTemplate/HumanMessagePromptTemplate/AIMessagePromptTemplate 조합을 통해 대화 목록 전체를 프롬프트로 구성한다.
참고. MessagesPlaceholder
# MessagesPlaceholder는 이전 대화 목록(List of Messages)이 들어갈 '빈 자릿표' 역할을 합니다.
prompt = ChatPromptTemplate.from_messages([
   ("system", "당신은 가상 RPG 게임의 친절한 안내원 '모험가 가이드'입니다."),
   # ★ 이전 대화 기록이 들어갈 위치 지정
   MessagesPlaceholder(variable_name="chat_history"),
   ("human", "{input}"),
])

chain = prompt | model

history = [
   HumanMessage(content="안녕! 내 캐릭터 이름은 '용사키우기'야."),
   AIMessage(content="반갑습니다, '용사키우기'님! 무엇을 도와드릴까요?")
]

response = chain.invoke({
   "chat_history": history, # MessagesPlaceholder 자리에 이 리스트가 삽입됨
   "input": "내 이름을 기억하고 있니?"
})
참고. MessagesPlaceholder: MessagesPlaceholder(variable_name=“chat_history”)는 이전 대화 내역(메시지 객체 리스트 전체)을 프롬프트의 특정 위치에 통째로 끼워 넣기 위한 예약 공간이다. 단순 문자열만 들어가는 일반 변수({input})와 달리 메시지 리스트를 그대로 주입할 수 있어, 챗봇이 이전 대화를 기억한 채 답하도록 만들 때 사용한다.
Structured Output
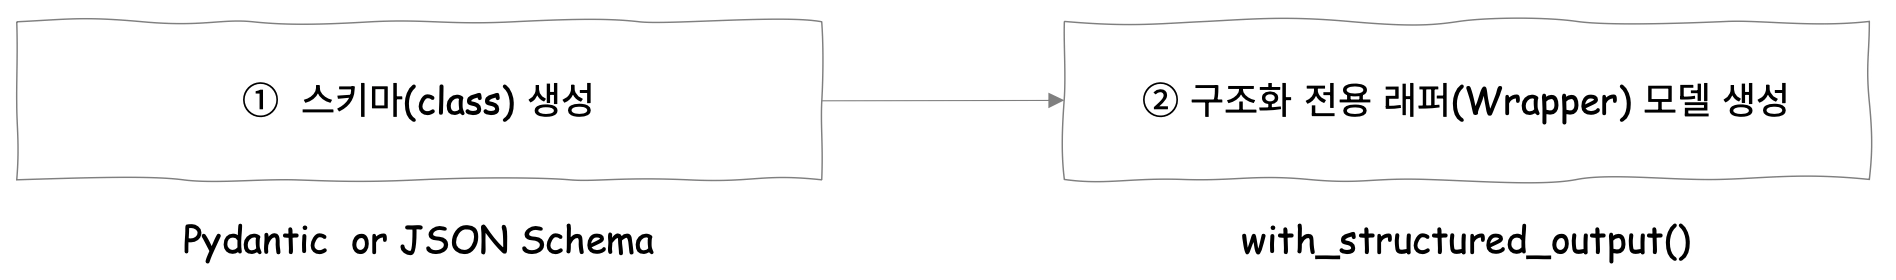
모델의 답변을 단순한 텍스트가 아니라 미리 약속한 정교한 데이터 형태로 받아내는 방법이다. DB 저장·API 호출·알림 발송 등 명확한 후속 작업을 가능하게 하며, 출력 형식을 명확히 정의해 JSON이나 Pydantic 모델 같은 정형 데이터를 자동으로 생성한다. 절차는 ① Pydantic 또는 JSON Schema로 스키마(class)를 만들고 ② model.with_structured_output(스키마)로 구조화 전용 래퍼 모델을 생성하는 두 단계다.
(1) Pydantic 방식
from pydantic import BaseModel, Field
from typing import Optional, Literal

class Movie(BaseModel):
   """상세한 영화 정보."""
   title: str = Field(description="영화의 제목 (예: 인셉션)")
   year: Optional[int] = Field(default=None, description="개봉 연도. 정보를 알 수 없다면 None.")
   genre: Literal["액션", "로맨스", "SF", "코미디", "기타"] = Field(description="영화의 장르")
   director: str = Field(description="영화 감독 이름")
   rating: float = Field(description="영화 평점 (10점 만점 기준)")
Pydantic 방식은 클래스 형태로 구조를 잡아 코드가 깔끔하고 IDE 자동완성을 지원받는다. Field(description=…)의 설명은 LLM이 값을 채울 때 참고하는 프롬프트 역할을 하므로, 예시나 제약 조건을 구체적으로 적을수록 정확도가 올라간다.
# 1. 스키마를 전달하여 구조화된 모델 생성
model_with_structure = model.with_structured_output(Movie)

# 2. 자연어 프롬프트로 호출
response = model_with_structure.invoke("영화 도둑들에 대해 설명해 주세요")

# 3. 결과 확인
print(response)

print(f"제목: {response.title} (타입: {type(response.title)})")
print(f"평점: {response.rating} (타입: {type(response.rating)})")
실행 결과는 response.title처럼 점(.) 접근이 가능하고 각 필드가 실제 타입(str, float 등)으로 캐스팅되어 바로 DB 저장이나 후속 로직에 활용할 수 있다.
(2) JSON Schema 방식 — 스키마를 딕셔너리로 정의하며, 파이썬에 종속되지 않아 언어 중립적인 스키마가 필요할 때 유용하다. 결과는 딕셔너리 형태로 반환되어 response['title']처럼 키로 접근한다. JSON Schema 방식은 이후 모델 호출 시 스키마 키나 설명 문구에 제약이 생길 수 있으므로, 키 값은 영문·숫자·언더스코어·대시로만 작성하는 것이 안전하다.
import json

json_schema = {
   "title": "Movie",
   "description": "A movie with details",
   "type": "object",
   "properties": {
      "title": {
         "type": "string",
         "description": "The title of the movie"
      },
      "year": {
         "type": "integer",
         "description": "The year the movie was released"
      },
      "director": {
         "type": "string",
         "description": "The director of the movie"
      },
      "rating": {
         "type": "number",
         "description": "The movie's rating out of 10"
      }
   },
   "required": ["title", "director", "rating"]
}
JSON Schema 방식은 스키마를 딕셔너리로 정의하며, 파이썬에 종속되지 않아 언어 중립적인 스키마가 필요할 때 유용하다. 키 값은 영문·숫자·언더스코어·대시로 작성하는 것이 안전하다.
# 1. JSON 스키마를 전달
model_with_structure = model.with_structured_output(json_schema)

# 2. 호출
response = model_with_structure.invoke("영화 극한직업에 대해서 소개해 주세요")

# 3. 결과 확인
print(response)

print(response['title'])
print(response['director'])
결과는 딕셔너리 형태로 반환되어 response[‘title’]처럼 키로 접근한다.
LCEL (LangChain Expression Language)
LangChain이 제공하는 선언적 방식의 인터페이스로, LLM·프롬프트·검색기·메모리 등 다양한 컴포넌트를 조합해 강력하고 유연한 AI 시스템을 구축한다.
주요 특징: 선언적 구문(간결하고 읽기 쉬움), 모듈성(컴포넌트 조합·재사용 용이), 유연성(다양한 애플리케이션 구축), 확장성(사용자 정의 컴포넌트 통합), 최적화(실행 시 자동 최적화).
기본 구성 요소: Runnable(모든 LCEL 컴포넌트의 기본 클래스), Chain(여러 Runnable을 순차 실행), RunnableMap(여러 Runnable을 병렬 실행), RunnableSequence(Runnable의 시퀀스 정의), RunnableLambda(사용자 정의 함수를 Runnable로 래핑).
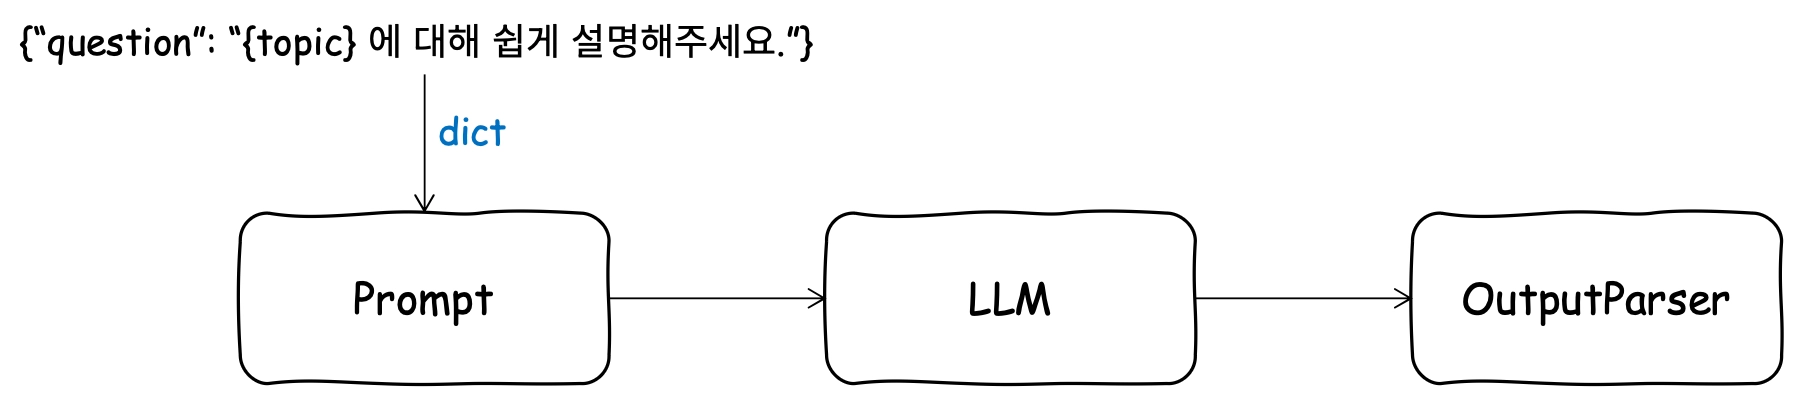
기본 구조: chain = prompt | model | output_parser. '|' 기호는 유닉스 파이프 연산자와 유사하게, 한 구성요소의 출력을 다음 구성요소의 입력으로 전달한다. 사용자 입력이 프롬프트 템플릿 → 모델 → OutputParser 순으로 흐른다.
코드 예시: Prompt | Model | OutputParser
from langchain_core.prompts import PromptTemplate

# prompt 를 PromptTemplate 객체로 생성합니다.
prompt = PromptTemplate.from_template("{topic} 에 대해 쉽게 설명해주세요.")

model = init_chat_model(model="gpt-4.1-nano", temperature=0.1)

# 프롬프트, 모델, 출력 파서를 연결하여 처리 체인을 구성합니다.
chain = prompt | model

# chain 객체의 invoke 메서드를 사용하여 input을 전달합니다.
input = {"topic": "인공지능 모델의 학습 원리"}
chain.invoke(input)
prompt | model로 체인을 구성해 invoke()를 호출하면 AIMessage 객체가 반환된다.
# 스트리밍 출력을 위한 요청
answer = chain.stream(input)
# 스트리밍 출력
for chunk in answer:
  print(chunk.content, end="", flush=True)
chain.stream(input)으로 스트리밍 출력도 가능하다. AIMessageChunk의 content를 출력한다.
from langchain_core.output_parsers import StrOutputParser

output_parser = StrOutputParser()

# 프롬프트, 모델, 출력 파서를 연결하여 처리 체인을 구성합니다.
chain = prompt | model | output_parser

# chain 객체의 invoke 메서드를 사용하여 input을 전달합니다.
input = {"topic": "인공지능 모델의 학습 원리"}
chain.invoke(input)
체인 끝에 StrOutputParser()를 추가하면 문자열만 바로 반환된다.
# 스트리밍 출력을 위한 요청
answer = chain.stream(input)
# 스트리밍 출력
for chunk in answer:
  print(chunk, end="", flush=True)
출력 파서가 문자열로 변환했으므로 chunk.content가 아니라 chunk 자체를 출력한다.
영어회화 실습 예시: "영어 회화: / 한글 해석:" 포맷을 지정한 프롬프트로 상황("식당에서 음식 주문", "미국에서 피자 주문")별 영어 회화 예문을 생성하는 체인을 구성한다.
template = """
당신은 영어를 가르치는 10년차 영어 선생님입니다. 주어진 상황에 맞는 영어 회화를 작성해 주세요.
양식은 [FORMAT]을 참고하여 작성해 주세요.

#상황:
{question}

#FORMAT:
- 영어 회화:
- 한글 해석:
"""

# 프롬프트 템플릿을 이용하여 프롬프트를 생성합니다.
prompt = PromptTemplate.from_template(template)

# ChatOpenAI 챗모델을 초기화합니다.
model = init_chat_model("gpt-4.1-nano")

# 문자열 출력 파서를 초기화합니다.
output_parser = StrOutputParser()

# 체인을 구성합니다.
chain = prompt | model | output_parser
“영어 회화: / 한글 해석:” 포맷을 지정한 프롬프트로 상황별 영어 회화 예문을 생성하는 체인을 구성한다.
# 완성된 Chain을 실행하여 답변을 얻습니다.
print(chain.invoke({"question": "저는 식당에 가서 음식을 주문하고 싶어요"}))

# 완성된 Chain을 실행하여 답변을 얻습니다.
# 스트리밍 출력을 위한 요청
answer = chain.stream({"question": "저는 식당에 가서 음식을 주문하고 싶어요"})
# 스트리밍 출력
for chunk in answer:
  print(chunk, end="", flush=True)
같은 식당 주문 상황을 invoke와 stream 방식으로 각각 호출한다.
# 이번에는 question 을 '미국에서 피자 주문'으로 설정하여 실행합니다.
# 스트리밍 출력을 위한 요청
answer = chain.stream({"question": "미국에서 피자 주문"})
# 스트리밍 출력
for chunk in answer:
  print(chunk, end="", flush=True)
question만 바꾸어 “미국에서 피자 주문” 상황의 영어 회화 예문을 생성한다.
LCEL 인터페이스
| 메서드 | 설명 |
| stream | 응답의 청크를 스트리밍 |
| invoke | 입력에 대해 체인을 호출 |
| batch | 입력 목록에 대해 체인을 호출(여러 개를 병렬 처리, max_concurrency로 동시 처리 수 제한 가능) |
| astream | 비동기적으로 응답 청크를 스트리밍(async for로 순회) |
| ainvoke | 비동기적으로 체인을 호출(await로 대기) |
| abatch | 비동기적으로 입력 목록을 일괄 처리(await로 대기) |
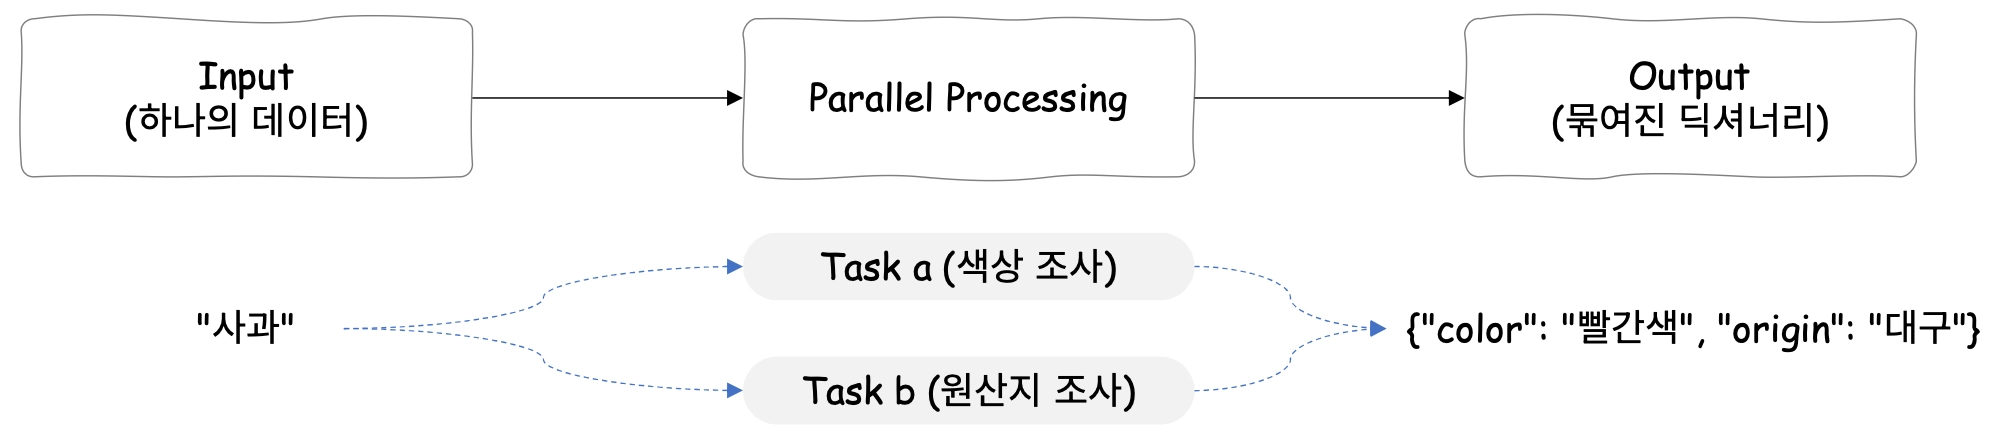
parallel(병렬성): 여러 개의 독립적인 태스크(LLM 호출, DB 조회 등)를 동시에 처리해 전체 실행 시간을 단축한다. 하나의 입력값을 여러 서브 체인에 동시에 전달(데이터 분기)한 뒤, 각 결과를 지정한 key로 하나의 딕셔너리에 묶어 다음 체인에 넘긴다. 예를 들어 "사과"라는 입력을 색상 조사 체인·원산지 조사 체인에 동시에 넣어 {"color": "빨간색", "origin": "대구"} 형태로 병합할 수 있다. RunnableParallel(capital=chain1, area=chain2)처럼 여러 체인을 묶으면 combined.invoke(...)나 combined.batch([...])로 한 번에 병렬·배치 실행할 수 있다.
from langchain_core.runnables import RunnableParallel

# {country} 의 수도를 물어보는 체인을 생성합니다.
chain1 = (
  PromptTemplate.from_template("{country} 의 수도는 어디야?")
  | model
  | StrOutputParser()
)
# {country} 의 면적을 물어보는 체인을 생성합니다.
chain2 = (
  PromptTemplate.from_template("{country} 의 면적은 얼마야?")
  | model
  | StrOutputParser()
)

# 위의 2개 체인을 동시에 생성하는 병렬 실행 체인을 생성합니다.
combined = RunnableParallel(capital=chain1, area=chain2)
여러 개의 독립적인 태스크를 동시에 처리해 전체 실행 시간을 단축한다. 하나의 입력값을 여러 서브 체인에 동시에 전달한 뒤, 각 결과를 지정한 key로 하나의 딕셔너리에 묶는다.
# chain1 (수도) 를 실행합니다.
chain1.invoke({"country": "대한민국"})

# chain2 (국토 면적) 를 실행합니다.
chain2.invoke({"country": "미국"})

# 병렬 (수도, 국토 면적) 실행 체인을 실행합니다.
combined.invoke({"country": "대한민국"})
수도·면적 조사 체인을 따로 호출하거나 combined.invoke()로 병렬 실행할 수 있다.
# 배치 처리를 수행합니다.
chain1.batch([{"country": "대한민국"}, {"country": "미국"}])

# 배치 처리를 수행합니다.
chain2.batch([{"country": "대한민국"}, {"country": "미국"}])

# 주어진 데이터를 배치로 처리합니다.
combined.batch([{"country": "대한민국"}, {"country": "미국"}])
combined.batch()로 여러 나라에 대한 병렬 체인을 배치 실행할 수 있다.
Runnable 유형
| Runnable | 역할 |
| RunnablePassthrough | 입력 데이터를 그대로 전달. 변환이 필요 없거나 파이프라인 특정 단계를 건너뛸 때, 디버깅 시 데이터 흐름을 모니터링할 때 사용 |
| RunnableLambda | 사용자 정의 함수를 Runnable로 래핑해 실행. 데이터 전처리, 계산, 외부 API 호출 등 커스텀 로직에 사용 |
| RunnableParallel | 여러 체인을 병렬 실행. 한 Runnable의 출력을 다음 Runnable의 입력 형식에 맞게 조작할 때도 활용 |
| RunnableBranch | 조건 분기(If-Else) 체인 구현. 입력 데이터에 따라 다른 체인을 실행하며, LCEL 파이프라인의 라우팅/분기 처리에 핵심적으로 활용 |
- 예시 1 — RunnableParallel + RunnablePassthrough
from langchain_core.runnables import RunnableParallel, RunnablePassthrough

runnable = RunnableParallel(
  # 전달된 입력을 그대로 반환하는 Runnable을 설정합니다.
  passed=RunnablePassthrough(),
  # 입력의 "num" 값에 3을 곱한 결과를 반환하는 Runnable을 설정합니다.
  extra=RunnablePassthrough.assign(mult=lambda x: x["num"] * 3),
  # 입력의 "num" 값에 1을 더한 결과를 반환하는 Runnable을 설정합니다.
  modified=lambda x: x["num"] + 1,
)

# {"num": 1}을 입력으로 Runnable을 실행합니다.
runnable.invoke({"num": 1})
예시 1(RunnableParallel + RunnablePassthrough): 입력 {“num”: 1} 하나로 ① 원본 그대로 반환(passed) ② “num”에 3을 곱한 결과를 새 키로 추가(extra, RunnablePassthrough.assign) ③ “num”에 1을 더한 결과만 반환(modified, lambda) — 세 작업을 동시에 수행해 하나의 딕셔너리로 묶는다.
- 예시 2 — 찬반 관점 병렬 실행
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

prompt1 = ChatPromptTemplate.from_messages([("system", "긍정적인 측면으로 답하세요."), ("human", "{q}")])
prompt2 = ChatPromptTemplate.from_messages([("system", "부정적인 측면으로 답하세요."), ("human", "{q}")])

parser = StrOutputParser()

chain1 = prompt1 | model | parser
chain2 = prompt2 | model | parser

act = RunnableParallel(
  question=RunnablePassthrough() | itemgetter("q"), # 입력을 통과시킨 뒤 q 값만 추출
  positive=chain1,
  negative=chain2,
)
out = act.invoke({"q": "2배 레버리지 ETF 투자에 대해 어떻게 생각하세요?"})

print("Question:", out["question"])
print("*** Answer POSITIVE:", out["positive"][:70], "...")
print("*** Answer NEGATIVE:", out["negative"][:70], "...")
예시 2(RunnableParallel + RunnablePassthrough): 같은 질문(“2배 레버리지 ETF 투자에 대해 어떻게 생각하세요?”)을 긍정적 관점 프롬프트와 부정적 관점 프롬프트 두 체인에 동시에 넣고, itemgetter로 원 질문(question)까지 함께 딕셔너리로 묶어 반환한다. 찬반 양쪽 관점을 한 번에 받아보는 패턴이다.
- 예시 3(RunnableLambda): 예시 2의 결과(positive/negative)를 RunnableLambda(combine_text)로 하나의 문자열로 합친 뒤, 다시 "자연스럽게 200자 이내로 교정해줘요" 프롬프트에 넣어 최종 요약 답변을 만드는 체인을 이어붙인다. 여러 체인을 연쇄적으로 파이프라인화하는 패턴이다.
def combine_text(text):
  return f"positive : {text["positive"]} negative : {text["negative"]}"
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableLambda

sum_prompt = ChatPromptTemplate.from_messages([("system", "다음 내용을 자연스럽게 200자 이내로 교정해줘요"), ("human", "{info}")])

sum_act = act | {"info": RunnableLambda(combine_text)} | sum_prompt | model | StrOutputParser()

sum_out = sum_act.invoke({"q": "2배 레버리지 ETF 투자에 대해 어떻게 생각하세요?"})
sum_out
예시 3(RunnableLambda): 예시 2의 결과(positive/negative)를 RunnableLambda(combine_text)로 하나의 문자열로 합친 뒤, 다시 “자연스럽게 200자 이내로 교정해줘요” 프롬프트에 넣어 최종 요약 답변을 만드는 체인을 이어붙인다. 여러 체인을 연쇄적으로 파이프라인화하는 패턴이다.
- 예시 4(RunnableBranch): 사용자 질문을 먼저 "수학/과학/기타" 중 하나로 분류하는 체인을 거친 뒤, RunnableBranch가 분류 결과에 따라 각기 다른 페르소나 프롬프트(math_chain은 "파스칼선생님께서 말씀하시기를..", science_chain은 "뉴턴선생님께서 말씀하시기를..", 그 외는 general_chain)로 라우팅하는 조건 분기 예시다. 전체는 {"topic": chain, "question": RunnablePassthrough()} | branch | StrOutputParser()로 구성되어, 분류 → 분기 → 답변 생성이 하나의 체인으로 연결된다.
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate

prompt = PromptTemplate.from_template(
  """주어진 사용자 질문을 `수학`, `과학`, 또는 `기타` 중 하나로 분류하세요. 한 단어 이상으로 응답하지 마세요.

{question}

Classification:"""
)

# 체인을 생성합니다.
chain = (
  prompt
  | ChatOpenAI(model="gpt-4o-mini")
  | StrOutputParser() # 문자열 출력 파서를 사용합니다.
)
사용자 질문을 먼저 “수학/과학/기타” 중 하나로 분류한다.
math_chain = (
  PromptTemplate.from_template(
     """You are an expert in math. \
Always answer questions starting with "파스칼선생님께서 말씀하시기를..". \
Respond to the following question:

Question: {question}
Answer:""" )
  | ChatOpenAI(model="gpt-4o-mini")
)

science_chain = (
  PromptTemplate.from_template(
     """You are an expert in science. \
Always answer questions starting with "뉴턴선생님께서 말씀하시기를..". \
Respond to the following question:
Question: {question}
Answer:""" )
  | ChatOpenAI(model="gpt-4o-mini")
)

general_chain = (
  PromptTemplate.from_template(
     """Respond to the following question concisely:
Question: {question}
Answer:""" )
  | ChatOpenAI(model="gpt-4o-mini")
)
분류 결과에 따라 사용할 수학·과학·일반 답변 체인을 각각 정의한다. math_chain은 “파스칼선생님께서 말씀하시기를..”, science_chain은 “뉴턴선생님께서 말씀하시기를..“로 답하도록 구성한다.
# RunnableBranch 로 분기
from langchain_core.runnables import RunnableBranch

branch = RunnableBranch(
  # 주제에 "수학"이 포함되어 있는 경우, math_chain을 실행
  (lambda x: "수학" in x["topic"].lower(), math_chain),
  # 주제에 "과학"이 포함되어 있는 경우, science_chain을 실행
  (lambda x: "과학" in x["topic"].lower(), science_chain),
  # 그 외의 경우 general_chain을 실행
  general_chain,
)

from operator import itemgetter
from langchain_core.runnables import RunnablePassthrough

full_chain = (
   {"topic": chain, "question": RunnablePassthrough()}
   | branch
   | StrOutputParser()
)
RunnableBranch가 분류 결과에 따라 다른 체인으로 라우팅한다. 분류 → 분기 → 답변 생성이 하나의 체인으로 연결된다.
Tool Calling
LLM이 단순히 텍스트를 생성하는 것을 넘어, 외부 도구(API, 함수, 계산기, 데이터베이스 등)를 직접 호출할 수 있게 하는 LangChain의 핵심 기능이다. 도구 유형은 빌트인 도구(LangChain이 미리 정의해 제공하는 tool/toolkit)와 사용자 정의 도구(Custom Tool — langchain.tools의 @tool 데코레이터로 일반 함수를 도구로 변환)로 나뉜다.
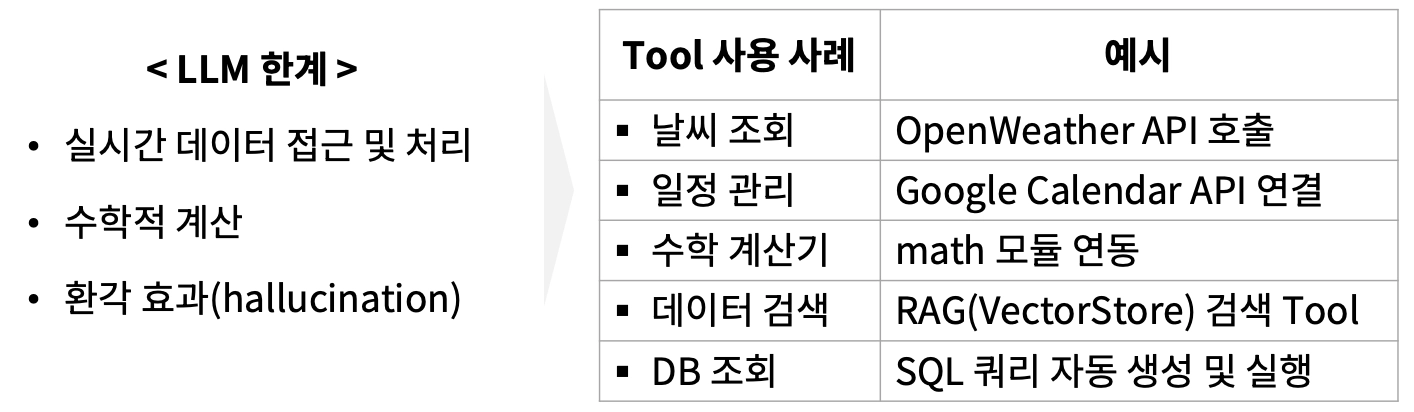
LLM의 한계(실시간 데이터 접근·처리, 수학적 계산, 환각 현상)를 도구 사용 사례(날씨 조회↔OpenWeather API, 일정 관리↔Google Calendar API, 수학 계산기↔math 모듈, 데이터 검색↔RAG 벡터스토어 검색, DB 조회↔SQL 쿼리 자동 생성)로 보완한다. 도구 사용의 장점은 확장성(LLM+실제 기능 결합), 지능적 선택(모델이 언제 어떤 도구를 쓸지 스스로 판단), 자동 인자 매핑(LLM이 JSON 형태로 인자 생성), 명확한 로그·추적(호출된 함수 로깅), 안전성 제어(허용된 함수만 실행되도록 제한)다.
빌트인 도구 예시 — Tavily 검색
from langchain_tavily import TavilySearch

# 도구 생성
tool = TavilySearch(
  max_results=6,
  include_answer=True,
  include_raw_content=True,
  include_domains=["github.io", "wikidocs.net"],
)

# 도구 실행
tool.invoke({"query": "LangChain Tools 에 대해서 알려주세요"})
빌트인 도구 예시 — Tavily 검색: Tavily 검색 API를 쿼리해 JSON 결과를 반환하는, 포괄적이고 신뢰도 높은 검색 엔진이다. 주요 매개변수는 max_results(기본 5), search_depth(basic/advanced), include_domains/exclude_domains, include_answer, include_raw_content, include_images다. 사용법은 Tavily API 키를 발급받아 .env에 TAVILY_API_KEY로 저장하고 pip install -qU langchain-tavily로 설치한 뒤, TavilySearch(max_results=6, include_answer=True, …)를 생성해 tool.invoke({“query”: “…”})로 실행한다.
사용자 정의 도구 — @tool 데코레이터
from langchain.tools import tool

# 데코레이터를 사용하여 함수를 도구로 변환합니다.
@tool
def add_numbers(a: int, b: int) -> int:
  """Add two numbers"""
  return a + b

@tool
def multiply_numbers(a: int, b: int) -> int:
  """Multiply two numbers"""
  return a * b
일반 파이썬 함수를 도구로 변환한다. 함수 작성 → 타입 힌팅 → docstring으로 설명 작성 → @tool 적용 순서이며, docstring은 LLM이 도구의 용도를 이해하는 설명서 역할을 한다.
# 도구 실행
add_numbers.invoke({"a": 3, "b": 4})
두 수를 더한 7을 반환한다.
# 도구 실행
multiply_numbers.invoke({"a": 3, "b": 4})
두 수를 곱한 12를 반환한다. 도구는 invoke()로 직접 호출할 수도 있다.
4. Basic Agent
다루는 내용: Basic Agent, Tool 사용, Short-term Memory, 구조화된 답변
Agent란
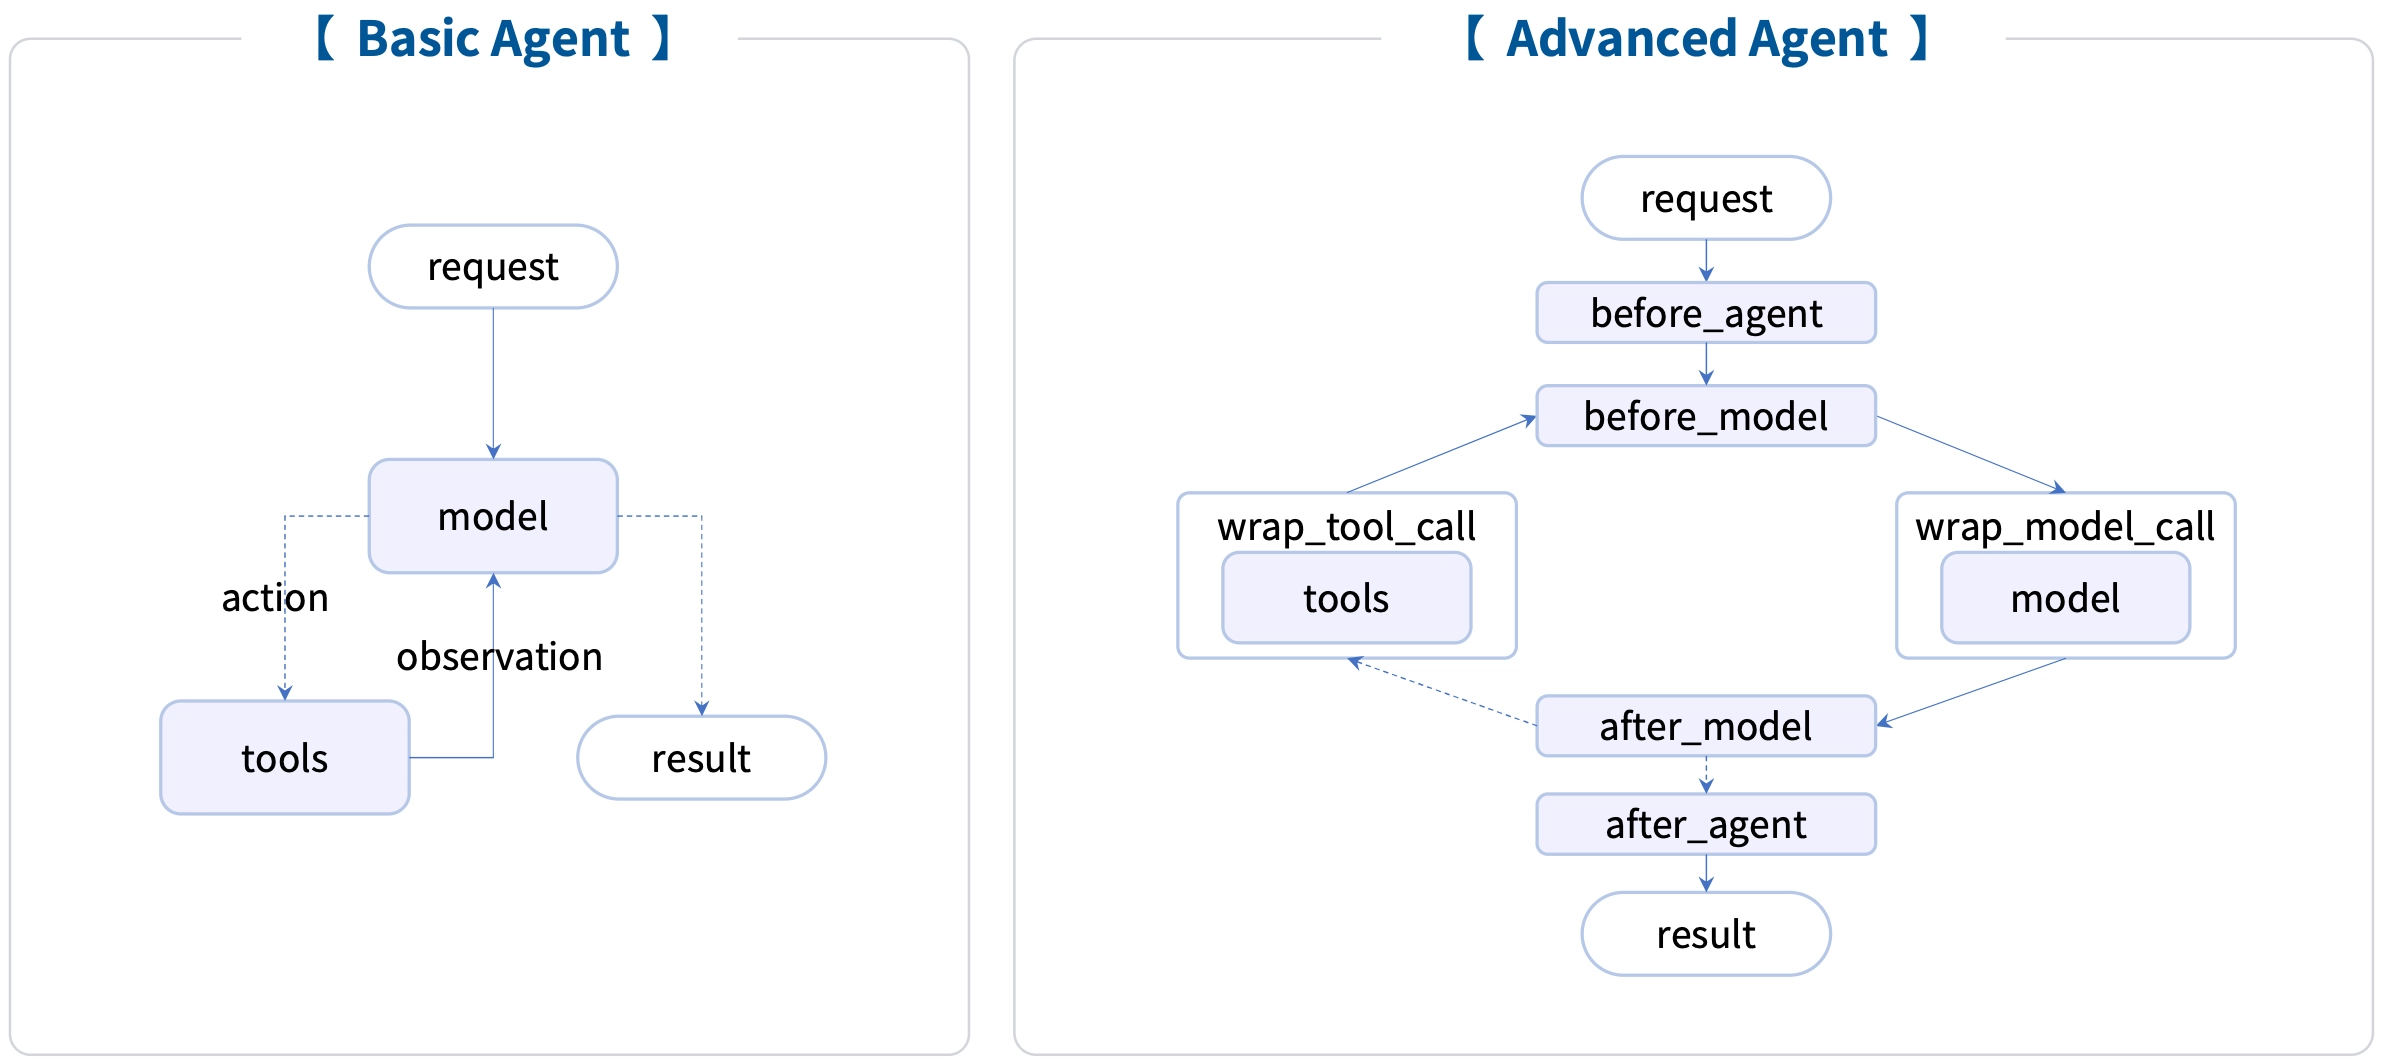
Agent는 사용자의 입력(질문, 지시)에 대해 적절한 행동을 취하도록 추론(Reasoning)한 뒤 행동(Act)하는 주체(Executor)다.
- Basic Agent 구조: request → model → (필요하면) tools → result의 단순한 흐름
- Advanced Agent(추후 과정) 구조: request → before_agent → before_model → wrap_model_call/model → wrap_tool_call/tools → after_model → after_agent → result처럼 여러 훅(hook)이 추가된 더 정교한 구조. 이번 Day1에서는 Basic Agent까지 다룬다.
Basic Agent Flow
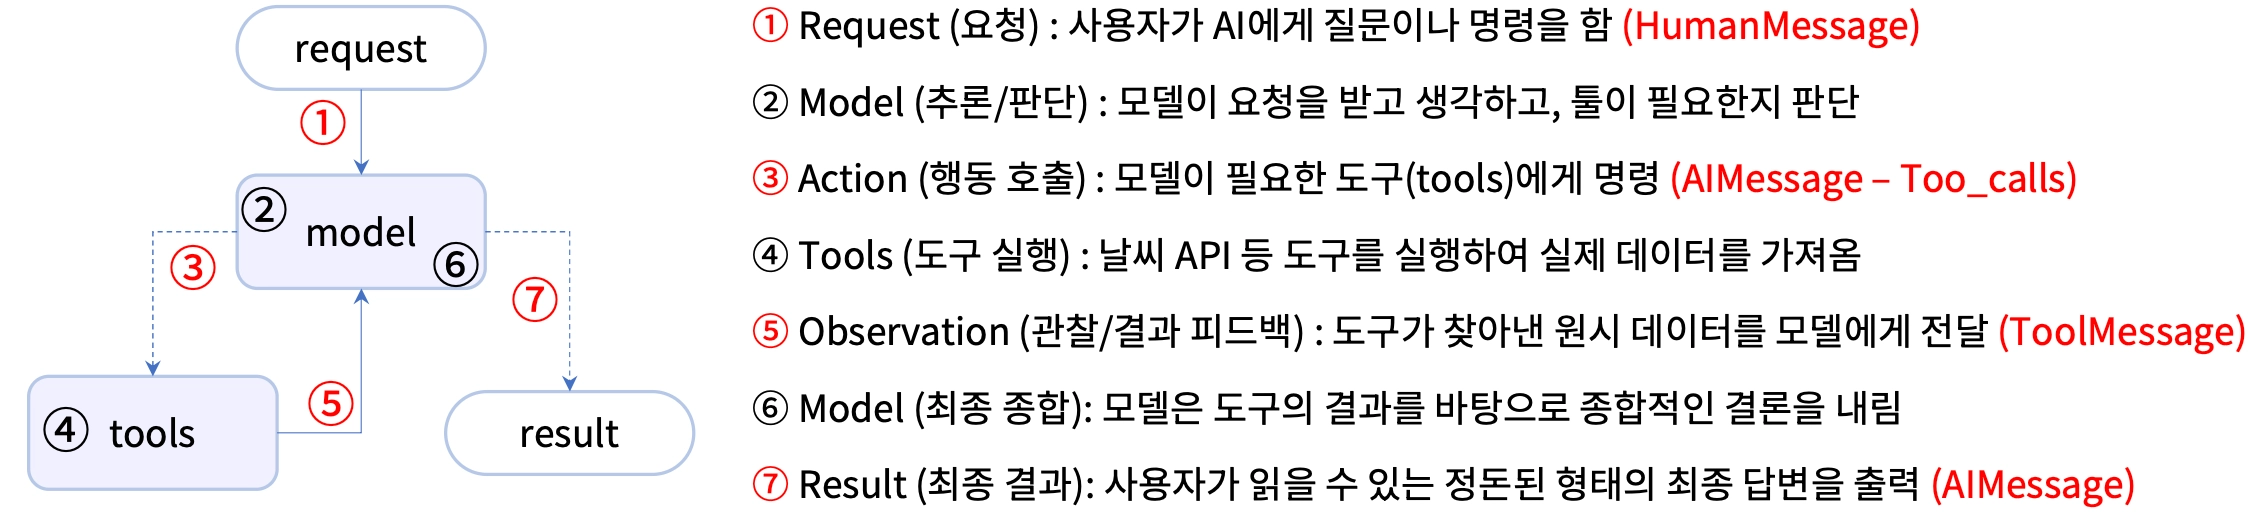
- 모델(두뇌 역할): 요청을 해석해 계획을 세우고, 내부 지식만으로 답할 수 없을 때(최신 정보 검색, 복잡한 계산 등) 어떤 도구를 쓸지 판단하며, 도구 결과를 보고 도구를 더 쓸지 최종 답을 낼지 결정한다.
- 도구(손발 역할): 모델이 갖지 못한 외부 기능·실시간 데이터 접근 수단이다. 웹 검색·계산기·캘린더·날씨 API 등 실제 작업을 수행하고 그 결과를 모델에 되돌려준다.
Agent 객체 생성
from langchain.agents import create_agent
- 도구 없이
from langchain.agents import create_agent

agent = create_agent(
  model = model,
)
model만 전달하면 도구 없는 에이전트를 생성한다.
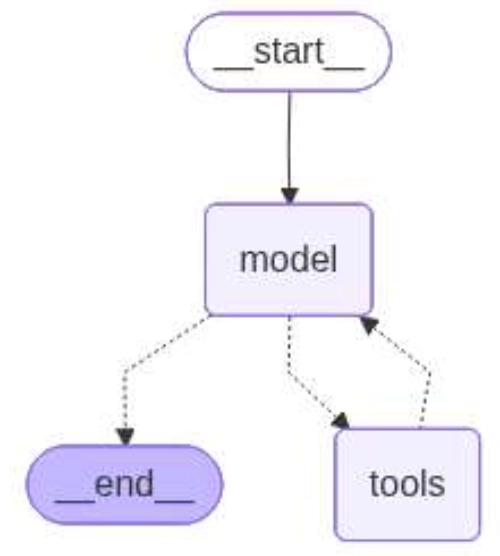
- 도구 포함: create_agent(model=model, tools=[get_weather])
from langchain.agents import create_agent

agent = create_agent(
  model = model, tools = [get_weather]
)
tools에 get_weather를 전달하면 날씨 도구를 사용할 수 있는 에이전트를 생성한다.
Tool 없는 Agent의 한계
도구 없는 모델 호출
from langchain.chat_models import init_chat_model
model = init_chat_model("gpt-5-nano")
response = model.invoke("현재 한국 날씨 어때?")
response.pretty_print()
그래프 구조가 start → model → end로 단순하다(tools 노드 없음). model.invoke(“현재 한국 날씨 어때?”)라고 물으면, 모델은 실시간 정보를 직접 조회할 수 없어 “저는 실시간 정보를 직접 확인할 수 없어서…“라며 사용자에게 도시명을 다시 묻거나 기상청 사이트를 참고하라고 안내하는 데 그친다. 도구가 왜 필요한지를 보여주는 대조 예시다.
Tool 사용 > (1) 날씨
from langchain.tools import tool

@tool
def get_weather(location: str) -> str:
    "이 도구는 특정 지역의 날씨 정보를 반환함."
    return f"오늘 {location} 날씨는 비가 옵니다."

from langchain.agents import create_agent

agent = create_agent(
    model=model,
    tools=[get_weather]
)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "오늘 서울 날씨 어때요? 날씨에 따라 옷 스타일을 추천해줘요"}]},
)
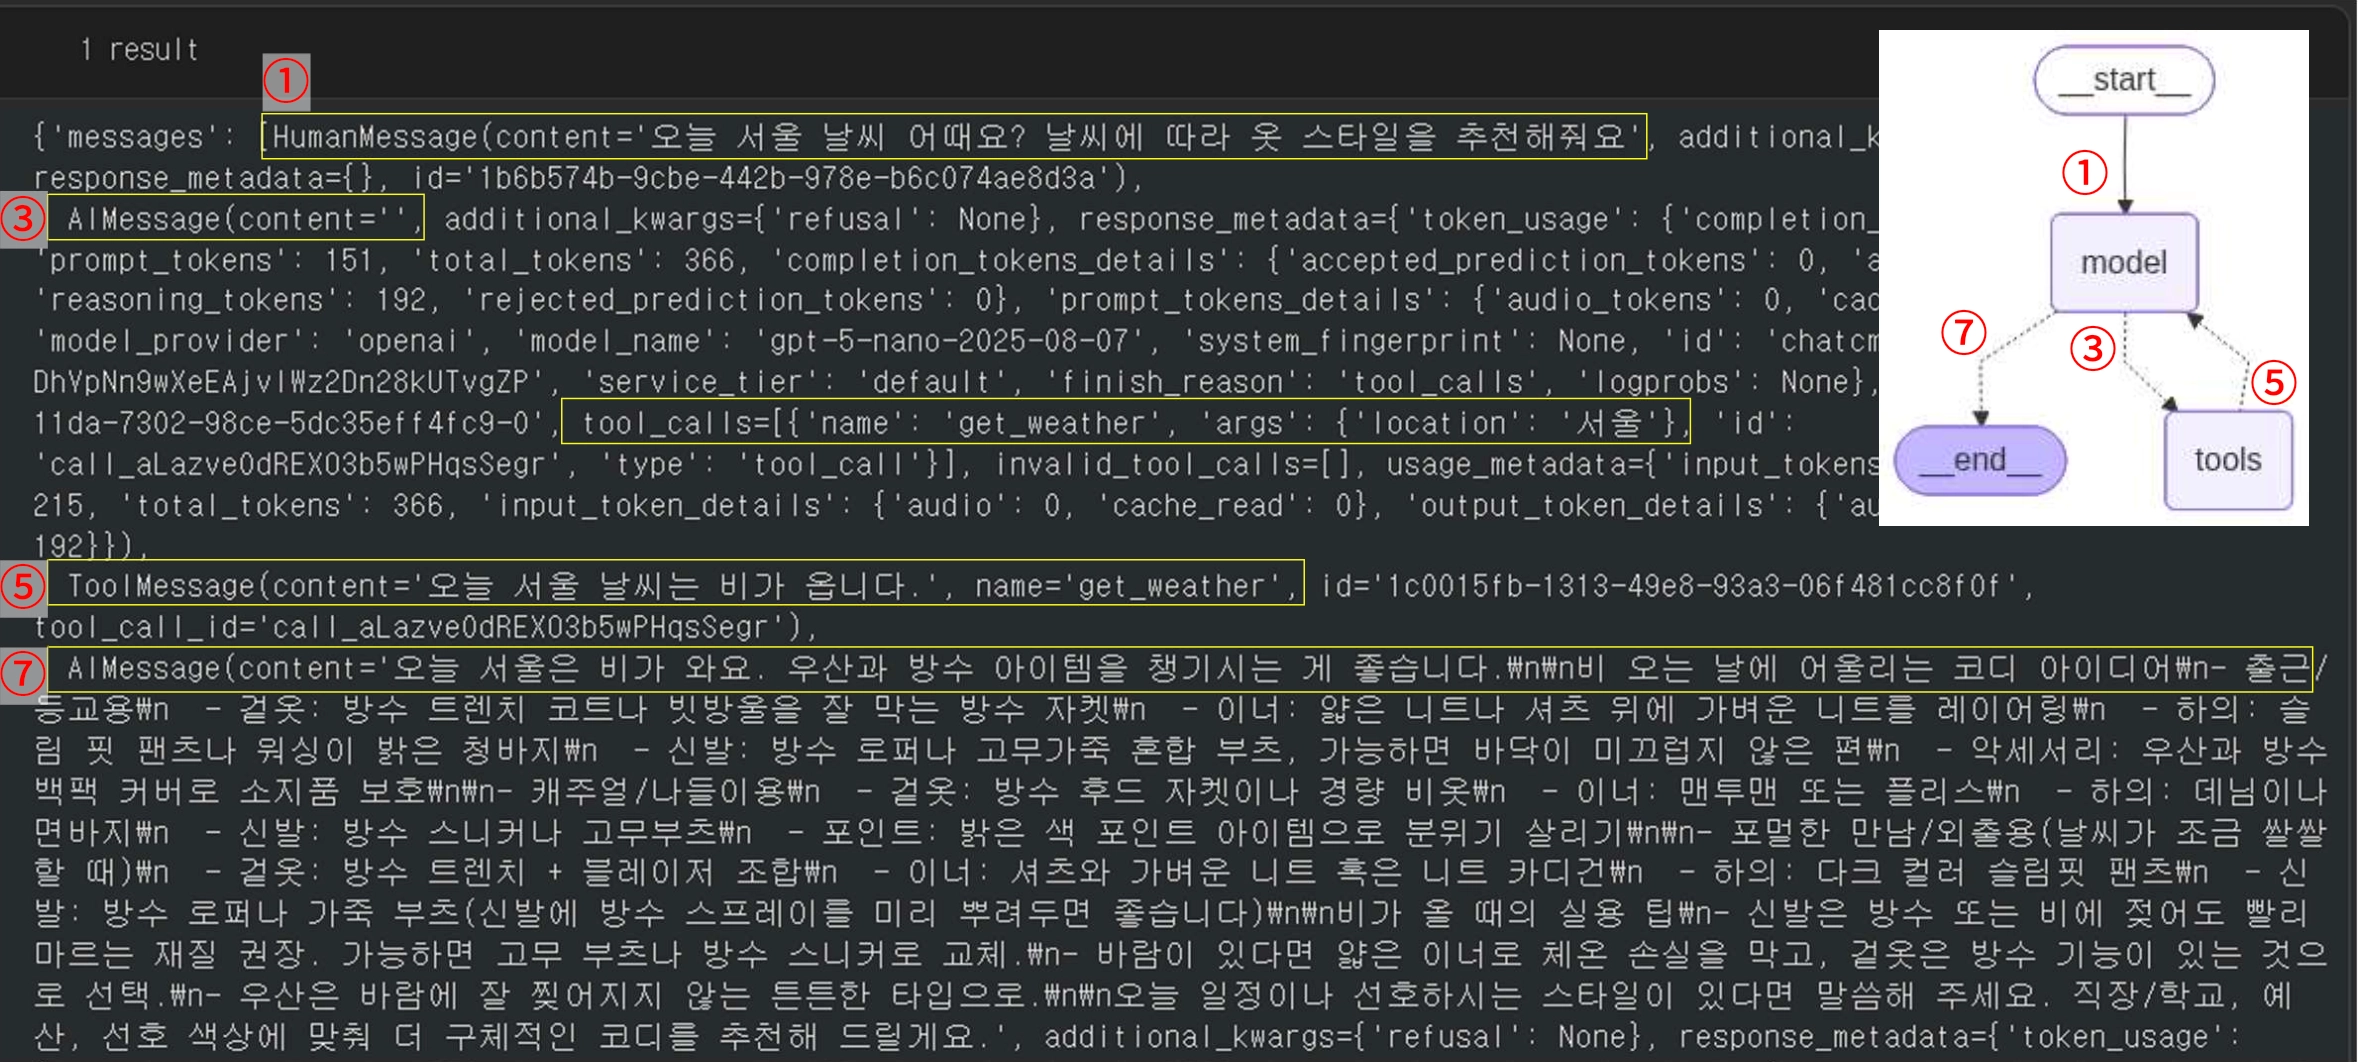
→ 3번에서 content=’’임.
→ 사용자에게 content 메시지를 보내는 대신 tool_calls로 도구 호출 명령을 사용했기 때문임
Tool 사용 > (2) 사칙 연산
사칙 연산 도구 정의
from langchain.tools import tool

@tool
def add(a: int, b: int) -> int:
  """`a`와 `b` 덧셈.

  Args:
     a: First int
     b: Second int
  """
  return a + b

@tool
def substract(a: int, b: int) -> int:
  """`a`에서 `b`를 빼기.

  Args:
     a: First int
     b: Second int
  """
  return a - b

@tool
def multiply(a: int, b: int) -> int:
  """`a`와 `b` 곱셈.

  Args:
     a: First int
     b: Second int
  """
  return a * b

@tool
def divide(a: int, b: int) -> float:
  """`a`와 `b` 나눗셈.

  Args:
     a: First int
     b: Second int
  """
  return a / b

tools = [add, substract, multiply, divide]
add, substract, multiply, divide 4개를 각각 @tool로 정의(docstring에 Args로 매개변수 설명 포함)하고 tools = [add, substract, multiply, divide]로 묶어 에이전트를 생성한다.
사칙 연산 에이전트 실행
agent = create_agent(
  model = model,
  tools = tools
)
result = agent.invoke(
  {"messages": [{"role": "user", "content": “30 + 5 * 2 은 뭔가요?"}]},
)
여러 연산이 섞인 질문을 던지는 예시다. 30 + 5 × 2의 답은 40이다. 교재의 content 시작 따옴표(“)는 원문대로 두었으며, 실행 시 일반 큰따옴표로 수정해야 한다.
agent = create_agent(
  model,
  tools,
  system_prompt="당신은 사칙연산할 때 무조건 도구를 호출하세요"
)
result = agent.invoke(
  {"messages": [{"role": "user", "content": "42 + 3 * 23은 뭔가요?"}]},
)
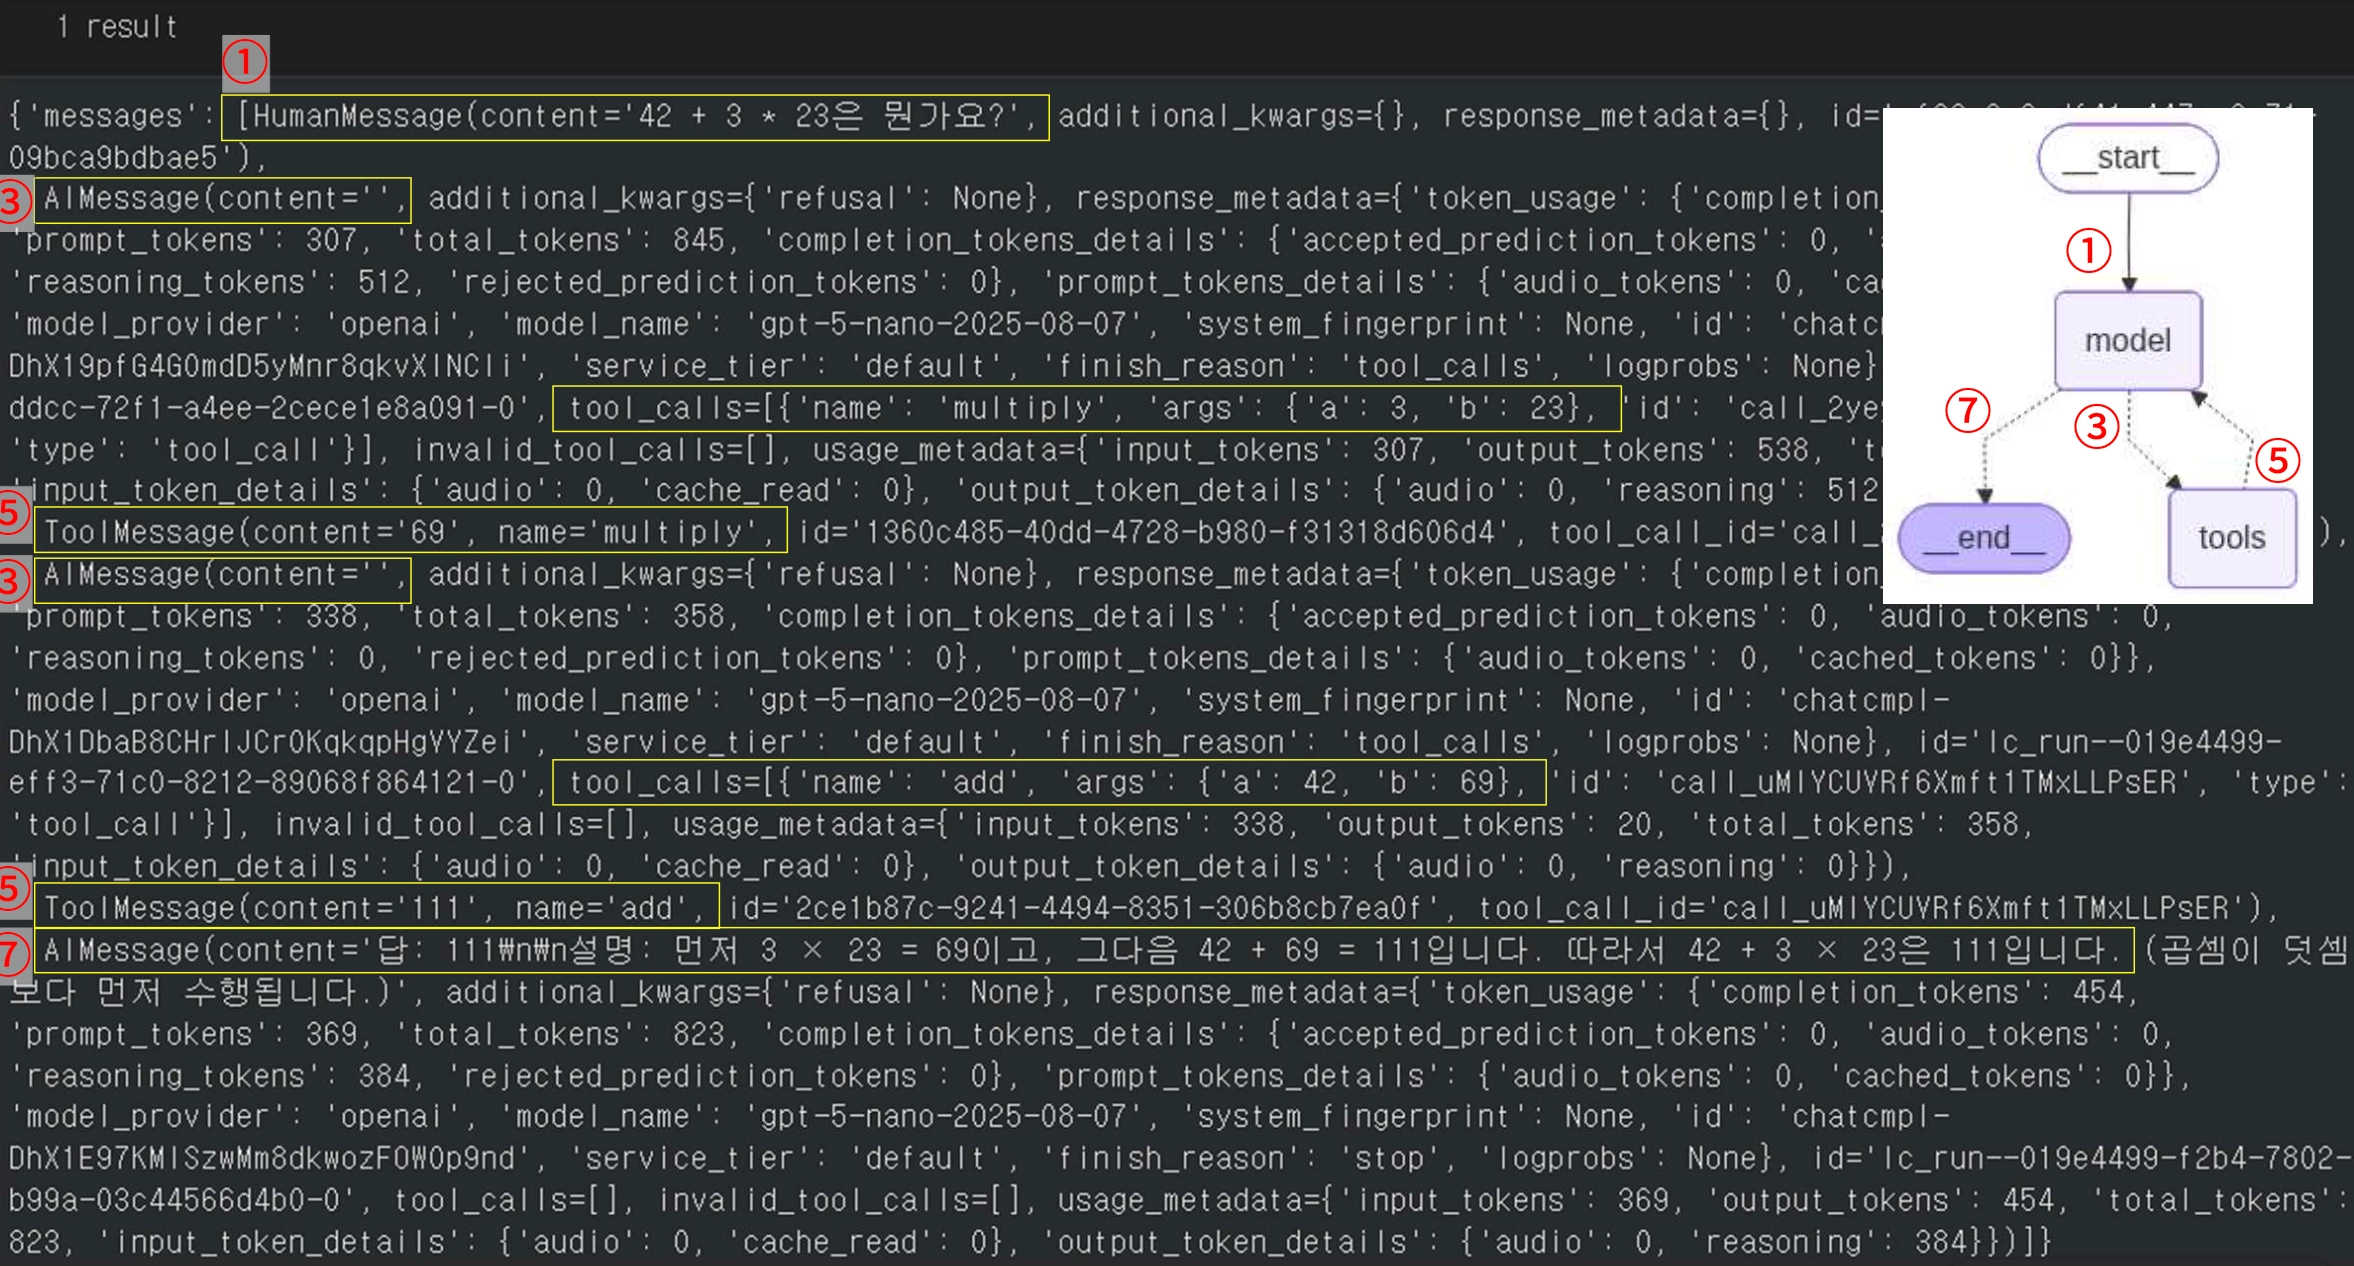
system_prompt로 사칙연산할 때 도구를 호출하도록 지시한다. 실행 로그에서는 HumanMessage → AIMessage(tool_calls: multiply) → ToolMessage(69) → AIMessage(tool_calls: add) → ToolMessage(111) → 최종 AIMessage 순으로, 3 × 23을 먼저 계산하고 42를 더하는 연쇄 호출을 확인할 수 있다.
Tool 사용 > (3) 알라딘 도서 API
알라딘 오픈API 키를 알라딘 OpenAPI 페이지에서 발급받아 사용한다(회원가입 필요).
from langchain.tools import tool
from typing import List, Dict, Any
import requests

@tool
def fetch_aladin_bestseller_topN(top_n: int) -> List[Dict[str, Any]]:
    """
    알라딘 베스트셀러 목록을 조회하고 Top N개(기본 1)를 반환합니다.

    Args:
        top_n: Top 개수 (값이 없을 때는 1로 하며, 10을 초과하는 경우 10으로 함)
    """
    url = "<http://www.aladin.co.kr/ttb/api/ItemList.aspx>"
    params = {
        "ttbkey": "key…", # Key 입력
        "QueryType": "Bestseller",
        "MaxResults": top_n,
        "start": 1,
        "SearchTarget": "Book",
        "output": "js",
        "Version": "20131101"
    }
    resp = requests.get(url, params=params)
    resp.raise_for_status()
    data = resp.json()
    items = data.get("item", [])
    top10 = items[:10]
    return top10
알라딘 도서 조회 에이전트 실행
agent = create_agent(
  model,
  [fetch_aladin_bestseller_topN],
)
response = agent.invoke(
  {"messages": [{"role": "user", "content": "현재 알라딘에서 베스트셀러 Top 4가 뭐야?"}]},
)
response['messages'][-1].content
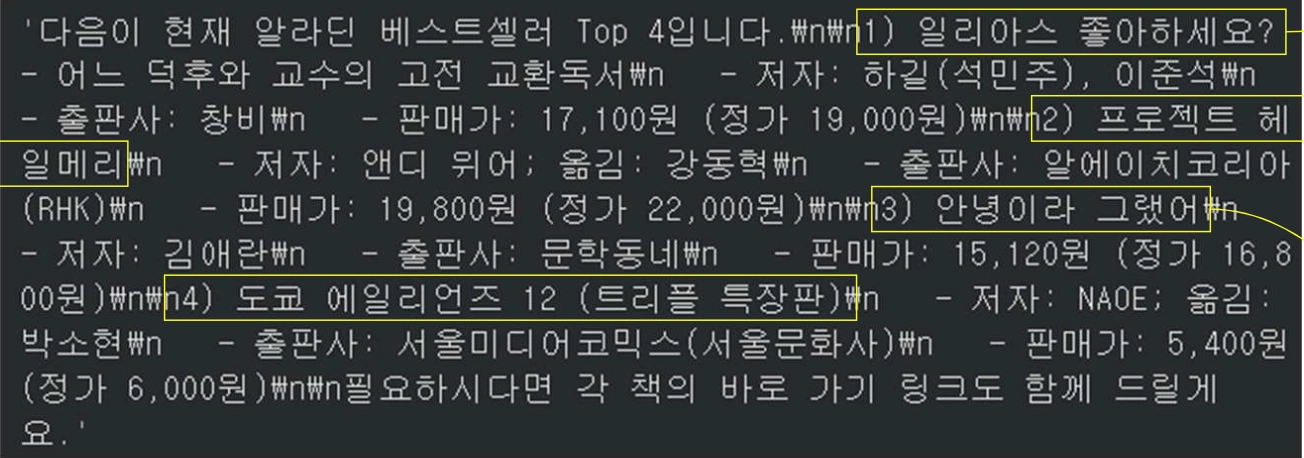
create_agent(model, [fetch_aladin_bestseller_topN])로 에이전트를 만들어 “현재 알라딘에서 베스트셀러 Top 4가 뭐야?“라고 물으면, 도구가 실제 알라딘 API를 호출해 가져온 책 목록(제목·저자·출판사·판매가 등)을 정리해 답변한다. 실제 알라딘 웹사이트의 베스트셀러 화면과 대조해 결과가 정확히 일치함을 확인하는 실습이다.
Tool 사용 > (4) 챗봇
챗봇 도구 정의와 대화형 실행
@tool
def get_current_time() -> str:
  """현재 시간을 반환합니다."""

  # KST는 UTC+9
  kst = timezone(timedelta(hours=9))
  now_kst = datetime.datetime.now(kst)
  return now_kst.strftime("%Y년 %m월 %d일 %H시 %M분")
get_current_time은 KST 기준 현재 시각을 반환한다.
@tool
def calculate(expression: str) -> float:
  """수학 계산을 수행합니다.

  Args:
    expression: 계산할 수식 (예: "2 + 3 * 4")
  """
  try:
     result = eval(expression)
     return f"{expression} = {result}"
  except Exception as e:
     return f"계산 오류: {e}"
calculate는 문자열 수식을 eval로 계산한다. 교재 예시이며, 신뢰할 수 없는 입력을 그대로 eval에 전달하는 것은 위험하다.
@tool
def get_weather(city: str) -> str:
  """도시의 날씨를 조회합니다. 도시명은 한글로 해줘요

  Args:
    city: 도시 이름 (예: '서울', '부산', '제주')
  """
  # 실제로는 날씨 API 호출
  # 여기서는 예시 데이터 반환
  weather_data = {
     "서울": "맑음 ☀ 22°C",
     "부산": "흐림 ☁ 20°C",
     "제주": "비 🌧 18°C"
  }
  return weather_data.get(city, f"{city}의 날씨 정보를 찾을 수 없습니다.")
get_weather는 도시별 더미 날씨 데이터를 딕셔너리에서 조회한다.
# 도구 목록
tools = [get_current_time, calculate, get_weather]

agent = create_agent(
  model=model,
  tools = tools
)
세 도구를 tools로 묶어 에이전트를 생성한다.
# 대화형 질의
print("질문을 입력하세요 (종료: exit or quit)")
while True:
    question = input("\n질문: ")
    if question.lower() in ['exit', 'quit', '종료', '끝']:
        print("종료합니다.")
        break

    response = agent.invoke({"messages": [{"role": "user", "content": question}]})

    # print(f"답변: {response}")
    print(f"답변: {response["messages"][-1].content}")
while True 루프에서 사용자 입력을 받아 agent.invoke()로 응답한다. “지금 몇시예요?”, “제주 날씨 알려줘”처럼 질문 종류에 따라 모델이 알맞은 도구를 선택한다. exit, quit, 종료, 끝을 입력하면 종료한다.
단기 메모리 (Short-term Memory)
다중 턴 대화에서 이전 맥락을 고려한 도구 호출을 위해서는 메모리 관리가 필요하다.
- 단기 메모리: checkpointer를 통해 하나의 대화 스레드(세션) 안에서만 맥락이 이어지는 기억이다. 채팅방을 나가거나 새로고침하면 보통 초기화된다.
- checkpointer(기억 보관소): 에이전트가 나눈 대화 기록(State)을 저장하고 필요할 때 꺼내오는 저장소
- thread_id(기억의 열쇠): 수많은 대화 기록 중 지금 이어갈 대화가 무엇인지 식별하는 고유 키. 같은 thread_id를 넘기면 기존 맥락을 이어가고, 다른 thread_id를 넘기면 완전히 새로운 대화로 시작한다.
- 장기 메모리: Store를 통해 세션(채팅방)을 넘나들며 영구적으로 유지되는 핵심 기억이다(예: 사용자의 직업, 선호 말투, 알레르기 정보 같은 개인 프로필). ChatGPT의 '개인 맞춤 설정'이 대표적인 예다. 이번 Day1은 단기 메모리까지 다루고, 장기 메모리는 이후 Advanced Agent 과정에서 다룬다.
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model,
    tools,
    checkpointer=InMemorySaver(),
)

response = agent.invoke(
    {"messages": [{"role": "user", "content": "안녕하세요. 저는 Jumany입니다."}]},
    {"configurable": {"thread_id": "thread_1"}},
)

response = agent.invoke(
    {"messages": [{"role": "user", "content": "안녕하세요. 제 이름이 뭐죠?"}]},
    {"configurable": {"thread_id": "thread_1"}},
)
다른 thread_id로 호출
response = agent.invoke(
   {"messages": [
       {"role": "user",
        "content": "안녕하세요. 제 이름이 뭐죠?"}
       ]
    },
   {"configurable": {"thread_id": "thread_2"}},
 )
앞의 예제는 같은 thread_1에서 “저는 Jumany입니다” → “제 이름이 뭐죠?”에 이름을 기억해 답하는지 확인한다. 위처럼 새 thread_id인 thread_2로 같은 질문을 하면, 해당 스레드에는 이전 대화가 없어 이름을 모른다고 답한다. 메모리가 thread_id 단위로 격리되어 있음을 보여주는 대조 실험이다.
구조화된 답변 (Structured Outputs)
Agent의 실행 결과를 자연어가 아니라 특정 포맷의 구조화된 데이터로 파싱하는 기능이다. 예시 시나리오는 이메일의 의도·감정 상태·요약·다음 수행 업무를 분석해 구조화된 데이터로 만드는 자동화 파이프라인이다.
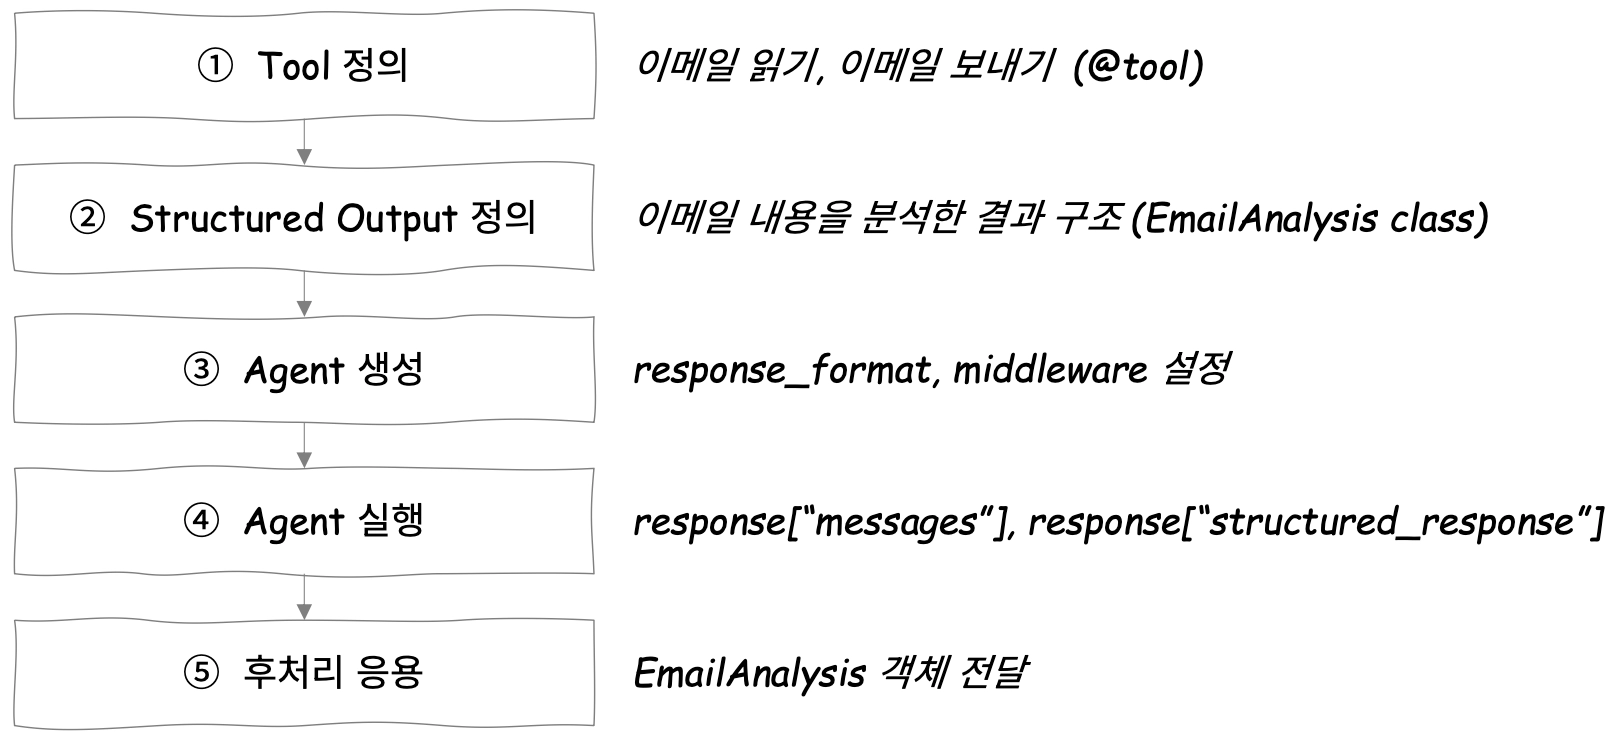
① Tool 정의:
from langchain.tools import tool
from typing import List, Dict

# 이메일 전송 도구
@tool
def send_email_tool(to: str, subject: str, body: str) -> str:
  """
  지정한 이메일 주소로 메일을 보내는 도구입니다.
  """
  return f"✅ 이메일이 성공적으로 전송되었습니다.\n수신자: {to}\n제목: {subject}\n내용: {body[:50]}..."

# 이메일 읽기 도구
@tool
def read_email_tool(limit: int = 3) -> str:
  """
  고객이 온라인 쇼핑몰에 보낸 컴플레인, 문의, 혹은 확인 관련 이메일을 읽는 도구입니다.
  """
  return f"✅ 이메일이 성공적으로 조회되었습니다."
② Structured Output 정의
from pydantic import BaseModel, Field
from typing import Literal

# Structured Output 정의
class EmailAnalysis(BaseModel):
   """이메일 내용을 분석한 결과 구조."""
   intent: Literal["complaint", "inquiry", "confirmation", "other"] = Field(
      description="이메일의 주요 의도 (예: complaint=불만, inquiry=문의, confirmation=확인, other=기타)"
   )
   sentiment: Literal["positive", "negative", "neutral"] = Field(description="이메일의 감정 상태")
   summary: str = Field(description="이메일 내용 요약")
   next_action: str = Field(description="에이전트가 수행해야 할 다음 단계 (예: 회신, 확인, 무시 등)")
② Structured Output 정의 — Pydantic으로 EmailAnalysis 클래스를 정의한다. intent(complaint/inquiry/confirmation/other), sentiment(positive/negative/neutral), summary(요약), next_action(다음 수행 업무)를 Literal과 Field(description=…)로 각각 명시한다.
③ Agent 생성
from langchain.agents import create_agent
from langchain.agents.middleware import LLMToolEmulator
from langchain.agents.structured_output import ToolStrategy
from langchain.chat_models import init_chat_model
model = init_chat_model("gpt-5-nano")
tools = [send_email_tool, read_email_tool]
agent = create_agent(
  model=model,
  tools=tools,
  # 핵심: 최종 산출물의 규격을 EmailAnalysis 스키마로 강제합니다.
  response_format=ToolStrategy(EmailAnalysis),
  middleware=[
     # 이메일 도구가 실제 백엔드에 없더라도 가상으로 동작하게 해주는 실습용 미들웨어
     LLMToolEmulator(model="gpt-5-nano"),
  ],
)
ToolStrategy에 EmailAnalysis 스키마를 전달해 최종 산출물의 규격을 강제한다. LLMToolEmulator는 실제 이메일 API가 아직 없거나 호출 비용이 부담스러운 실습 상황에서, 언어 모델이 생성한 가상 데이터로 도구 호출을 흉내내주는 미들웨어다.
④ Agent 실행
response = agent.invoke(
  {
     "messages": [
       {"role": "user", "content": "최근 온 메일 확인하고 고객의 의도와 감정, 요약, 그리고 어떤 행동이 필요한지 분석하세요."}
     ]
  }
)
analysis = response["structured_response"]
최근 메일의 의도·감정·요약·다음 행동을 분석하도록 요청한다. response[“messages”]에는 이메일 조회 도구 호출과 결과 등 실행 메시지가 순서대로 기록되고, response[“structured_response”]에는 EmailAnalysis 스키마에 맞춘 결과 객체가 담긴다. 교재 결과는 complaint·negative로 분류하고, 배송 지연과 위치 확인 요청을 요약하며, 배송 일정 확인 후 회신과 환불 여부 확인을 다음 행동으로 제시한다.
⑤ 후처리 응용
# Pydantic 객체를 딕셔너리로 변환
data_for_db = analysis.model_dump()

# 구조화된 스키마 데이터를 기반으로 한 자동화 파이프라인 예시
if data_for_db["intent"] == "complaint" and data_for_db["sentiment"] == "negative":
   # 1. CS팀 슬랙 채널에 긴급 알림 전송 (API 호출)
   # 2. Jira 이슈 트래커에 '긴급(High)' 티켓 자동 생성
   print("🚨 [긴급] 불만 접수! CS팀에 즉시 알림을 전송합니다.")
   print(f"요약: {data_for_db['summary']}")
elif data_for_db["intent"] == "inquiry":
   # FAQ 데이터베이스 검색 후 자동 회신 스크립트 실행
   print("ℹ 일반 문의 접수. 자동 회신 프로세스를 시작합니다.")
analysis.model_dump()로 Pydantic 객체를 딕셔너리로 변환한다. complaint이면서 negative이면 CS팀 슬랙 알림·Jira 긴급 티켓, inquiry이면 FAQ 검색·자동 회신으로 연결하는 조건 분기 예시다. 위 코드는 안내 문구를 출력하며, 실제 알림·티켓 생성·회신 API는 주석의 위치에 별도로 구현한다.
'STUDYING' 카테고리의 다른 글
| [STUDYING] 39. 실전 Feature Engineering_핵심 정리 (1) | 2026.09.17 |
|---|---|
| [STUDYING] 38. 생성형 AI 서비스 개발의 이해/활용 (LangChain)_Day2_핵심 정리 (1) | 2026.09.10 |
| [STUDYING] 36. 쿠버네티스 이해 및 애플리케이션 배포_Day2_핵심 정리 (0) | 2026.09.08 |
| [STUDYING] 35. 쿠버네티스 이해 및 애플리케이션 배포_Day1_핵심 정리 (0) | 2026.09.07 |
| [STUDYING] 34. 데이터분석 및 AIOps_머신러닝 및 딥러닝 이해_C_핵심정리 (0) | 2026.09.02 |


