
- 분류 전체보기 (360)

- SQL (2)
- JAVA (6)
- REACT (3)
- OS (24)
- AI(ML & DL) (37)
- BLOCKCHAIN (15)
- ARCHITECTURE (7)
- BACKJOON (7)
- DOCKER (10)
- 취업 (1)
- GCP (8)
- TYPESCRIPT (10)
- MOBILE PROGRAMING (20)
- DATABASE DESIGN (18)
- AI(GNN) (2)
- ALGORITHM (14)
- CLAUD COMPUTERING (13)
- PYTHON (3)
- SPRING BOOT (13)
- INFLEARN (63)
- AI(MCP) (2)
- NETWORK (22)
- CODINGTEST (3)
- 기타 (6)
- STUDYING (50)
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- Algorithm
- Android
- AI
- inflearn
- Rag
- 배포
- springboot
- Network
- frontend
- LLM
- docker
- Spring
- http
- DB
- Database
- CS
- blockchain
- Design
- spring boot
- cloud
- architecture
- Python
- Studying
- SQL
- OS
- GCP
- Kotlin
- DL
- TypeScript
- java
- Today
- Total
소소한 지식 저장소
[STUDYING] 33. 데이터분석 및 AIOps_머신러닝 및 딥러닝 이해_B_핵심정리 본문
[STUDYING] 33. 데이터분석 및 AIOps_머신러닝 및 딥러닝 이해_B_핵심정리
ch010104 2026. 9. 2. 23:391. 회귀분석 재해석
1-1. 회귀방정식이란?
목적: 몸무게(X)로 키(Y)를 예측하는 것이 회귀분석의 목표. 데이터는 (몸무게, 키) 쌍으로 수집됨(예: 58→174, 59→175, 60→176). 선형회귀식은 y = ax + b 형태이며, 기울기(a)와 절편(b)을 합쳐 회귀계수라고 부름.
회귀계수를 구하는 접근 방안(반복적 시행착오):
- a, b는 아직 모르는 값이므로 임의의 값을 대입(예: a=1.2, b=100)
- 임의값으로 예측값 계산 → 몸무게 58일 때 y = 1.2*58 + 100 = 169.6
- 실제값(174)과 예측값(169.6)의 차이를 확인 → 차이 4.4
- 이 차이가 0에 가까워지도록 a, b를 반복적으로 조정 → 최적의 a, b 도출
1-2. 선형모델에서 알고 싶은 것은?
선형모델은 y = Wx + b 형태의 가설(Hypothesis)로 표현됨.
- 이미 알고 있는 것: x(독립변수, Feature — 모델 입력값), y(종속변수, Target — 모델 예측값과 비교할 결과값). 둘 다 데이터 수집을 통해 확보됨.
- 알고 싶은 것: W(가중치/기울기/회귀계수), b(절편/Bias). 이 둘을 파라미터라고 하며, 알고 있는 데이터(x,y)를 학습시켜 결정함.
- 가중치 W값에 따라 다양한 기울기의 직선이 존재할 수 있으므로, 데이터에 가장 잘 맞는 W와 b를 찾아야 함.
- 딥러닝에서 최적 파라미터를 계산하는 대표적 방법이 경사하강법(Gradient Descent)임.
1-3. 파라미터 구하는 과정 — 통계적(선형회귀) 접근
선형회귀분석에서 파라미터(기울기 W, 절편 b)를 구하는 5단계:
| 단계 | 내용 |
| Step 1 | 데이터 정의 (x, y) |
| Step 2 | 선형 모델 정의, 가설수립: y = Wx + b |
| Step 3 | 오차 평가/손실 함수 정의: MSE = (1/n)Σ(Yi - Ŷi)² |
| Step 4 | 오차 최소화: 최소자승법(Least Squares Method) |
| Step 5 | 파라미터 계산 → 예: y = 2.5x + 29 |
1-4. 파라미터 구하는 과정 — 딥러닝에 적용하면
위 5단계 중 Step 4(오차 최소화)의 방법이 딥러닝에서는 경사하강법(Gradient Descent)으로 바뀜.
- 경사하강법: 손실함수의 기울기(Gradient)를 낮은 값 쪽으로 이동(하강)시켜 근사값을 찾는 최적화 알고리즘. 손실함수가 최소가 되는 최적의 파라미터를 찾는 과정.
- 이 방법을 통해 회귀식의 파라미터(기울기, 절편)에 대한 최적해를 찾음.
- 전체 흐름: 데이터 준비 → 모델 구조 설정(W,b 초기화) → 평가 기준 마련 → 경사하강법으로 손실 최소 파라미터 탐색 → 학습을 통해 파라미터 업데이트
1-5. 회귀식을 구하는 과정 (Linear Regression 흐름)
전체 흐름: 데이터(x,y) → 회귀식 정의/가설(y=Wx+b) → 평가기준 정의(MSE) → 예측값 계산 → 잔차 계산 → 파라미터 계산 → 잔차가 0에 가까워지면 → 최적의 회귀식 확정
- Step1: 데이터 수집/저장, 학습 데이터셋 정의
- Step2: 문제 정의에 따라 Regression 또는 Classification 결정 (Regression은 y=Wx+b, 평가기준은 MSE/RMSE)
- Step3: 학습 모델(Wx+b)에 실제값 X를 넣어 예측값 계산
- Step4: 예측값과 실제값의 차이(잔차) 계산 → 파라미터(W,b)를 최소자승법 규칙으로 업데이트 → 반복하여 잔차가 최소(≈0)가 되는 최적 파라미터 산출
- Step5: 오차 최소가 되는 파라미터로 최적의 회귀식을 최종 확정
1-6. Statistics vs Deep Learning 비교
동일한 5단계 흐름이지만 딥러닝에서는 각 단계가 확장됨:
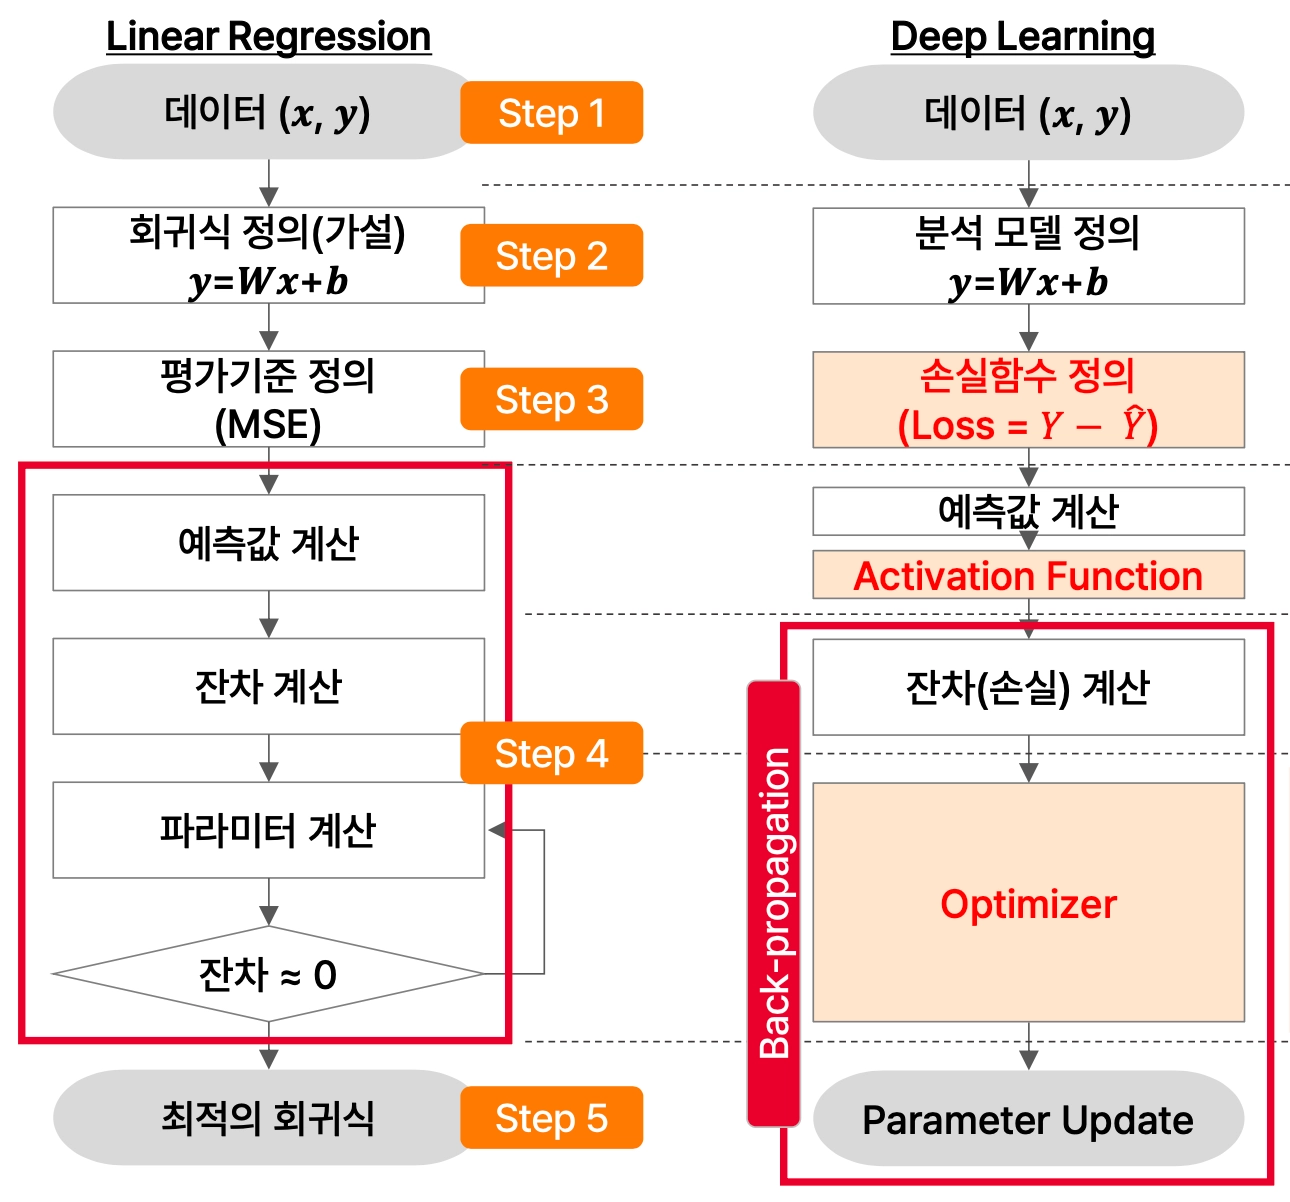
| 단계 | Linear Regression (통계) | Deep Learning |
| Step1 데이터 | 데이터(x,y) 수집 | 데이터(x,y) 수집, x→Feature, y→Target으로 정의 |
| Step2 모델 정의 | 회귀식 정의: y=Wx+b | 분석 모델 정의: y=Wx+b |
| Step3 평가기준 | MSE, RMSE | 손실함수/비용함수 정의(Loss = Y - Ŷ, 분류 문제는 Cross Entropy 등) — 오차를 수치화해 역전파에 필요한 정보 제공 |
| Step4 오차 최소화 | 최소자승법으로 잔차 계산 | 예측값 계산 시 Activation Function(예: ReLU)으로 비선형성 추가, 잔차(손실) 계산 후 Back-propagation 진행 |
| Step5 파라미터 계산 | 잔차≈0인 최적 회귀식 추정 | Optimizer가 Back-propagation 결과로 파라미터(W,b)를 업데이트하고, 반복 학습(Epoch)을 통해 가중치를 조정. Back-propagation은 손실이 가장 빠르게 줄어드는 방향으로 최적화 알고리즘이 조정 방향을 결정하는 과정 |
1-7. feat. Activation Function — 선형회귀에 비선형성 더하기
- 순수 선형회귀 노드: f(x) = Σ(xi*wi) + b — 입력의 가중합에 절편을 더한 값을 그대로 출력.
- 선형회귀 + 활성함수: 위 결과값에 활성함수(Activation Function)를 한 번 더 적용하여 출력 ŷ를 만듦.
- 이렇게 활성함수를 가진 노드를 여러 층(레이어)으로 쌓으면 선형회귀식을 비선형으로 확장한 딥러닝 아키텍처가 됨.
1-8. Activation Function — ReLU
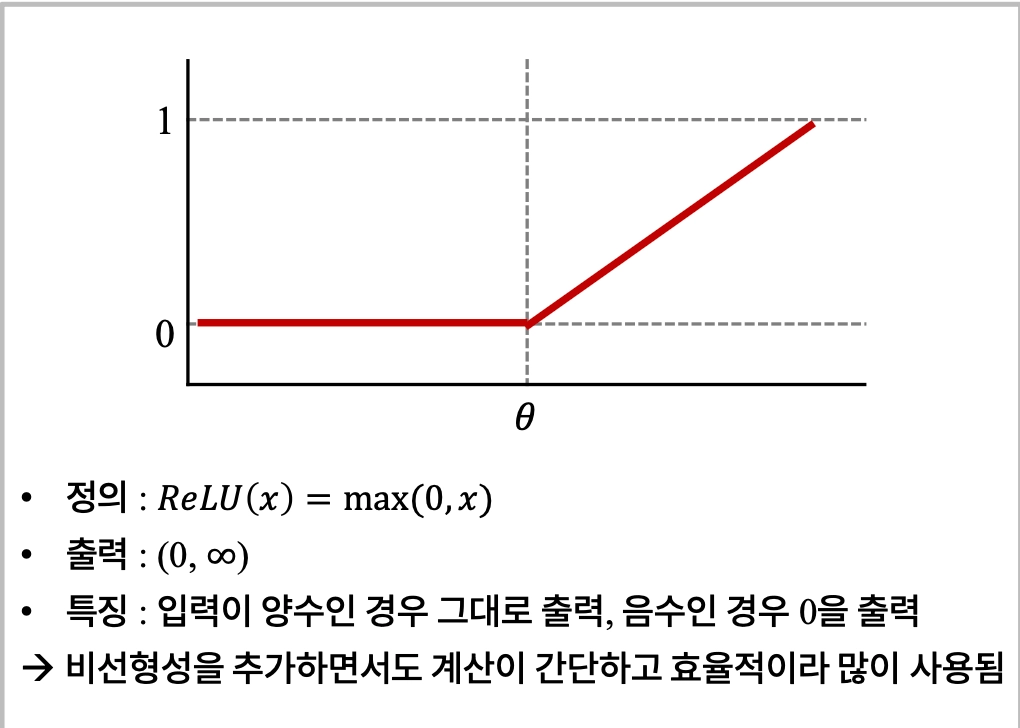
- 정의: ReLU(x) = max(0, x)
- 출력 범위: (0, ∞)
- 특징: 입력이 양수이면 그대로 출력하고, 음수이면 0을 출력함 → 비선형성을 추가하면서도 계산이 간단하고 효율적이라 널리 사용됨.
- 예시(사과 vs 오렌지 구분): 크기·색상 같은 특성을 입력하면 뉴런이 가중치·편향을 적용한 뒤 ReLU를 통과시킴. 사과에 가까운(의미 있는) 신호는 그대로 유지되고, 오렌지에 가까운(불필요한) 신호는 0으로 걸러짐. 이 과정이 반복되며 신경망은 사과/오렌지를 가르는 복잡한 비선형 경계를 형성하게 됨.
1-9. [참고] ReLU 쉽게 이해하기 — '음수 버리기'가 만드는 비선형성
- ReLU는 원래 직선(y=x)에서 음수 구간을 0으로 잘라버림 → 이 지점에서 한 번 꺾임(관절)이 생기고, 이 꺾임 자체가 비선형성의 원천이 됨.
- 이러한 꺾임(ReLU)을 여러 개 모아 이어붙이면, 곡선처럼 복잡한 패턴도 근사해서 표현할 수 있게 됨.
- 그 결과 하나의 곧은 직선으로는 나눌 수 없었던 데이터(예: 원형으로 분포된 두 그룹)도, 여러 개의 꺾인 경계선을 조합하면 성공적으로 구분할 수 있게 됨.
1-10. Activation Function — Sigmoid vs Tanh vs ReLU
| 구분 | Sigmoid | Tanh | ReLU |
| 정의 | σ(x) = 1 / (1 + e^-x) | tanh(x) = (e^x - e^-x) / (e^x + e^-x) | ReLU(x) = max(0, x) |
| 출력 범위 | (0, 1) | (-1, 1) | (0, ∞) |
| 특징 | 확률값 표현에 유용하나 입력이 극단적일 때 출력이 0 또는 1에 몰려 Gradient Vanishing이 발생하기 쉬움 | 출력이 0 중심으로 분포되어 Sigmoid보다 Gradient Vanishing이 덜함 | 계산이 간단하고 Vanishing 문제가 적으나, 일부 뉴런이 죽는(dying ReLU) 현상이 발생할 수 있음 |
| 주요 활용 | 이진 분류(Binary Classification), 확률 표현(Logistic Regression 등) | RNN, LSTM 등 출력이 양·음으로 나뉘는 문제 | 대부분의 신경망에서 기본 활성함수로 사용 |
2. 모델 최적화
2-1. 용어의 이해 — 최적화(Optimization)
- 사전적 의미: 주어진 조건이나 제약 내에서 최상의 결과를 얻도록 과정·방법을 조정·개선하는 것. 자원/시간/비용을 최소화하거나 효율성/효과성을 최대화하는 것이 목표(예: 경제학의 자원배분, 공학의 설계 최적화, 물류의 경로 최적화).
- 머신러닝 모델링에서의 최적화: 학습 과정에서 성능 지표를 개선하기 위해 파라미터를 조정하고 모델을 다듬어 최상의 성능을 얻는 과정. 주요 목표는 성능 향상, 일반화(새로운 데이터에 대한 대응력) 향상, 효율성(학습 속도·자원 사용) 증가 세 가지임.
2-2. 최적화 접근 — 딥러닝의 수학적 접근
딥러닝에서의 최적화는 특정 함수의 값을 최소화(또는 최대화)시키는 최적의 파라미터 조합을 찾는 문제로 귀결됨. 실제값과 예측값의 차이(Loss Function)를 최소화(Minimization)하는 방향으로 최적화를 수행함.
2-3. DL 최적화 흐름

딥러닝 모델 최적화는 Loss Function을 최소화하는 파라미터를 구하는 과정이며, 대표적으로 경사하강법을 사용함.
전체 흐름: 데이터(x,y)를 Epoch 단위로 반복 학습 → 분석 모델 정의(y=Wx+b) → 손실함수 정의(Loss = Y - Ŷ) → Activation Function을 거쳐 예측값 계산 → 잔차(손실) 계산 → Optimizer가 파라미터 업데이트.
- Forward Propagation: Input Layer → Hidden Layer → Output Layer로 신호가 전달되며 예측값(Ŷ)과 LOSS가 계산됨.
- Back Propagation: 계산된 LOSS를 바탕으로 Weight를 업데이트하며, Parameter Optimization(SGD, Adam 등) 알고리즘이 이 과정을 담당함.
2-4. Gradient Descent(경사하강법)
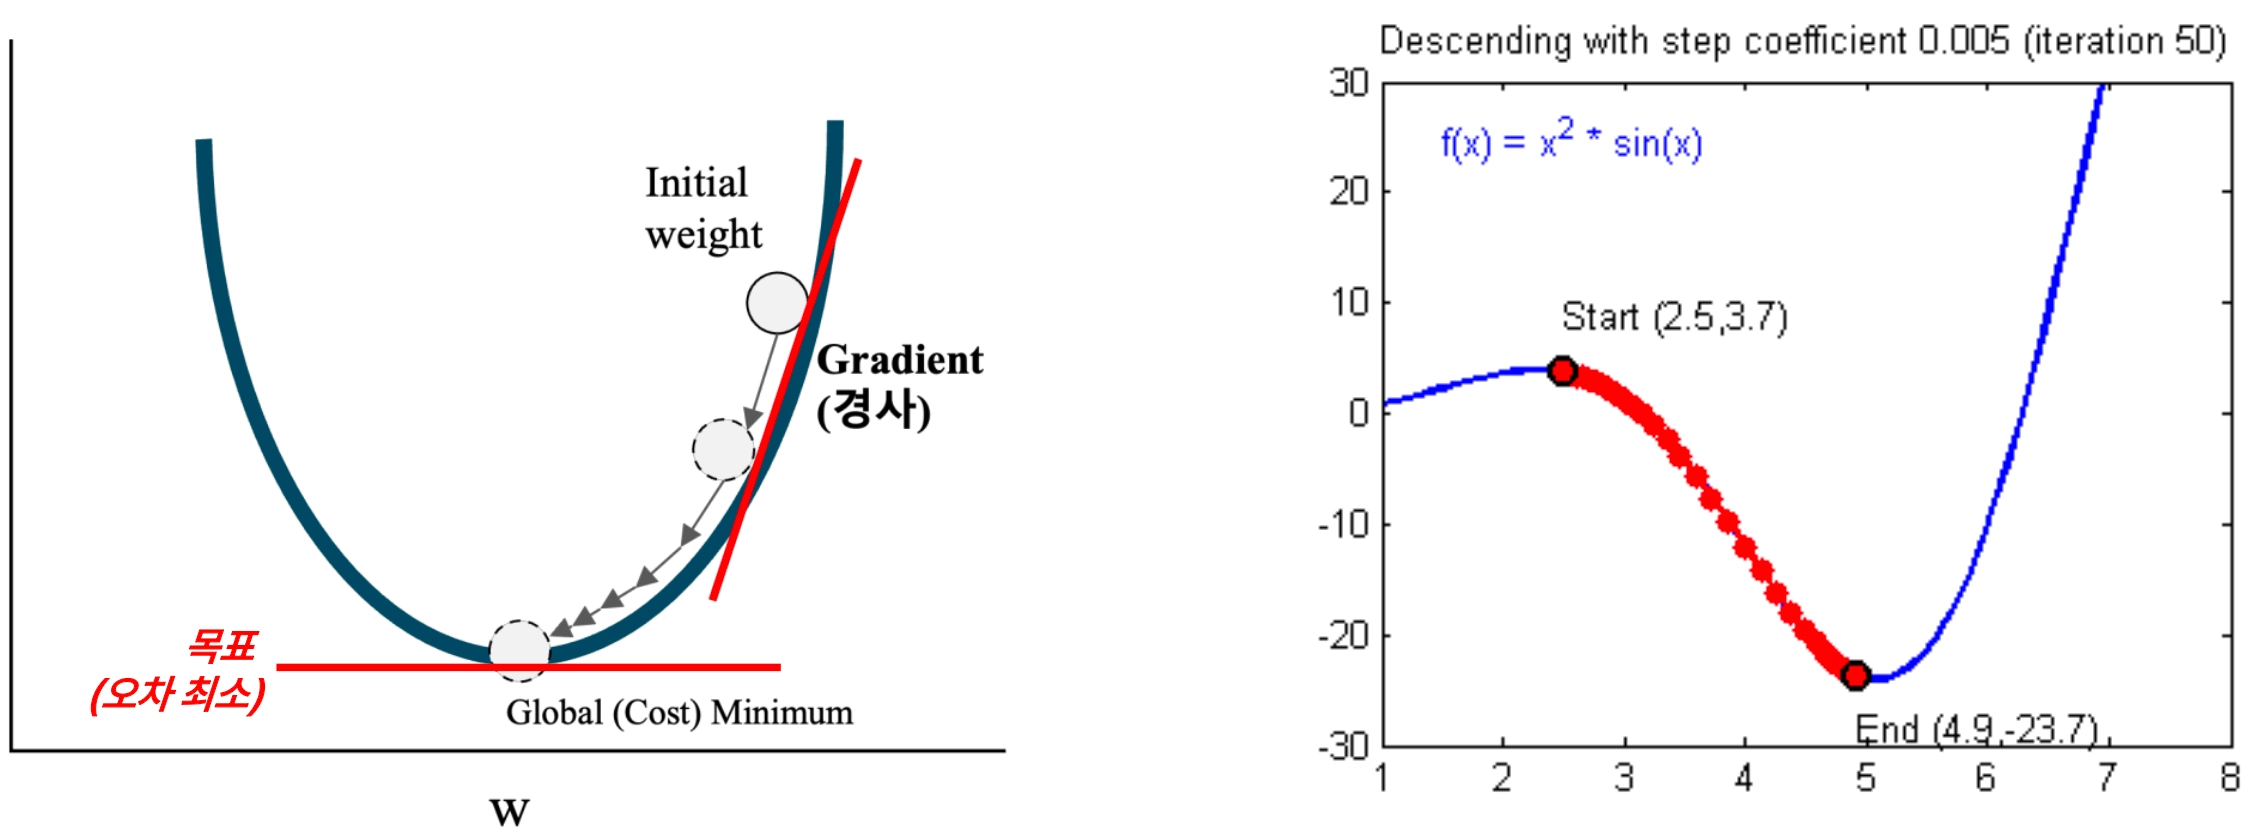
- Optimizer의 초기 버전으로, 함수의 기울기(경사, Gradient)를 이용해 X값을 어느 방향으로 옮겨야 함수가 최소값을 갖는지 찾아내는 방법.
- 초기 가중치(Initial weight)에서 시작하여 기울기(Gradient) 방향을 따라 목표 지점인 Global(Cost) Minimum까지 점차 이동함.
- 예시 함수 f(x) = x² * sin(x)에서 step coefficient 0.005, 반복 50회로 이동했을 때 시작점(2.5, 3.7)에서 종료점(4.9, -23.7)까지 수렴하는 모습을 확인할 수 있음.
2-5. Learning Rate(학습률)
가중치가 한 번에 얼마나 변할지를 조정하는 값으로, Global Minimum에 잘 가까워지도록 적절히 설정해야 하는 하이퍼파라미터임(Hyper-parameter Tuning의 대상).
- 0과 1 사이 값을 가지며 사람이 직접 설정함.
- 값이 작을수록: 파라미터를 촘촘하게 변화시켜 정밀하지만 학습 시간이 오래 걸림.
- 값이 클수록: 손실함수 그래프 자체를 벗어나 버리는 Over-shooting이 발생할 수 있음.
- 적정 학습률은 보통 10^-5 수준의 작은 비율로 시작해 튜닝을 통해 최적화하며, 학습 초반에는 큰 스텝으로 빠르게 탐색하다가 Global Minimum에 가까워질수록 스텝을 줄여 정밀 탐색하는 전략이 유효함.
- 기울기(∂E/∂Wt): 손실함수(E)가 가중치(Wt)에 대해 얼마나 빠르게, 어느 방향으로 변하는지를 나타냄.
- 가중치 업데이트 공식: 새 가중치 = 현재 가중치 - 학습률 × 기울기 (*Wt = Wt - η × ∂E/∂Wt)
2-6. [참고] Optimizer & Learning Rate 쉽게 이해하기
- Gradient Descent = 산길 내려가기: 산 꼭대기(초기 가중치)에서 산 아래(최적점)로 내려갈 때, 경사면(기울기)을 보고 내려갈 방향을 정하는 것.
- Learning Rate = 한 걸음에 내려가는 거리: 한 번에 얼마나 큰 걸음으로 내려갈지 결정하는 값.
- 너무 작으면: 한 발씩 조심스럽게 내려가 안전하지만 시간이 오래 걸림.
- 너무 크면: 두세 걸음씩 뛰어내려가다 목표 지점을 지나쳐 길을 벗어날 수 있음(Over-shooting).
- 공식에서 Wt는 현재 위치(가중치), η는 한 걸음에 내려갈 거리(학습률), ∂E/∂Wt는 경사면의 기울기, 새 Wt는 경사를 보고 한 걸음 내려간 다음 위치(새 가중치)를 의미함.
2-7. [참고] Gradient Descent의 한계 — Local Minimum
가장 가파른 방향만 따라 계속 내려가면 언젠가는 어떤 계곡(최소값 지점)에 도착하지만, 그 계곡이 정말 도달해야 할 최적 지점(Global Minimum)이라는 보장은 없음.
- 목적: 가장 낮은 곳(최소 손실값)을 찾는 것.
- 특징: 현재 위치 주변의 지역 정보만 사용해 산길을 내려가는 방식.
- 한계점: 실제로는 가장 낮은 지점이 아닌 국소적인 골짜기(Local Minimum)에 빠질 수 있고, 경사면이 완만한 구간에서는 이동 속도가 느려지며, 출발 위치에 따라 결과가 달라질 수 있음(항상 정답인 Global Minimum으로 가는 것은 아님).
2-8. Forward Propagation 계산 예시
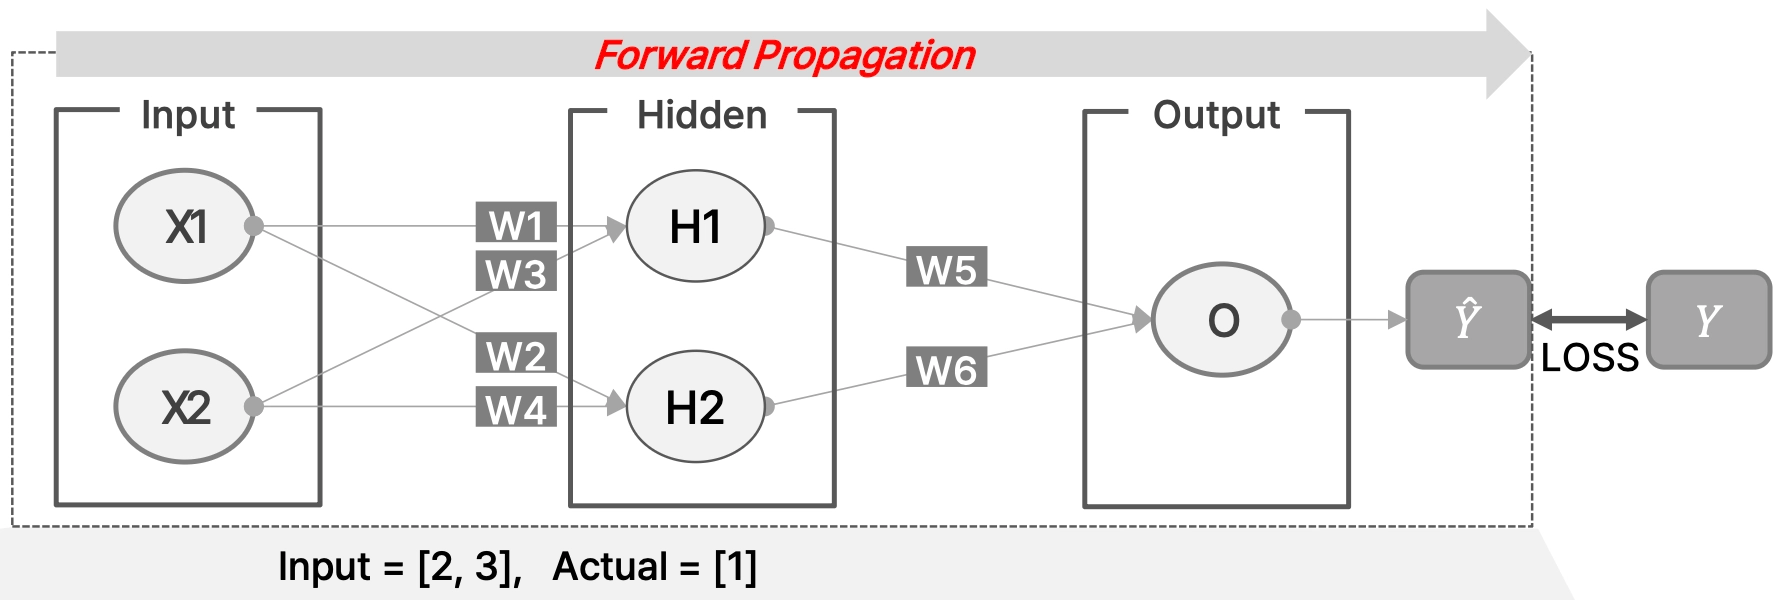
간단한 신경망(입력층 X1,X2 → 은닉층 H1,H2 → 출력층 O)을 예로 계산 과정을 살펴봄. 입력 X1=2, X2=3, 가중치 W1=0.11, W2=0.12, W3=0.21, W4=0.08(입력→은닉), W5=0.14, W6=0.15(은닉→출력).
- 은닉층 계산: H1 = X1*W1 + X2*W3 = 2*0.11 + 3*0.21 = 0.85, H2 = X1*W2 + X2*W4 = 2*0.12 + 3*0.08 = 0.48
- 출력층(예측값) 계산: O = H1*W5 + H2*W6 = 0.85*0.14 + 0.48*0.15 = 0.191
- 오차(Loss) 계산: Error = (1/2)(prediction - actual)². 제곱을 사용해 오차가 항상 양수가 되게 하고, 1/2을 곱해 미분 시 계산이 간단해지도록 함. 실제값(actual)이 1.0일 때 Error = (1/2)(0.191 - 1.0)² = 0.327
2-9. Backward Propagation — 수식 전개
Loss 함수 Error = (1/2)(prediction - actual)²를 출발점으로, prediction을 가중치들의 식으로 역방향 전개함.
- prediction = O = H1*W5 + H2*W6, 이때 H1 = X1*W1 + X2*W3, H2 = X1*W2 + X2*W4
- 따라서 prediction = (X1*W1 + X2*W3)*W5 + (X1*W2 + X2*W4)*W6
- W6 업데이트 공식: *W6 = W6 - η × ∂E/∂W6
- 체인룰로 전개하면 ∂E/∂W6 = (∂Error/∂prediction) × (∂prediction/∂W6) = (prediction - actual) × (X1*W2 + X2*W4) = Δ × H2
- 즉 은닉층 H2가 출력한 값의 오차는 그대로 가중치 W6를 업데이트하는 데 필요한 정보(ΔH2)가 됨.
2-10. Backpropagation 단계별 설명
위 W6 업데이트 유도 과정을 단계별로 다시 정리하면:
- 가중치 업데이트 수식(경사하강법): *W6 = W6 - η × ∂E/∂W6
- 체인룰 적용: ∂E/∂W6 = (∂Error/∂prediction) × (∂prediction/∂W6)
- 오차 함수 미분: ∂Error/∂prediction = prediction - actual — 기울기(∂E/∂W6)는 오차를 줄이기 위해 가중치를 얼마나, 어느 방향으로 조정해야 하는지 알려줌. 오차는 예측값에 따라 달라지므로, 오차를 예측값에 대해 먼저 미분하고 이어서 예측값을 가중치에 대해 미분함.
- 예측값에 대한 미분: ∂prediction/∂W6 = X1*W2 + X2*W4 — 식을 W6로 미분하면 W6와 무관한 첫째 항은 사라지고 둘째 항만 남음.
- 미분 결과 결합: ∂E/∂W6 = (prediction - actual) × (X1*W2 + X2*W4)
- 수식 정리: (X1*W2 + X2*W4)를 H2로 치환하면 ∂E/∂W6 = Δ × H2. 여기서 Δ는 오차(delta), H2는 은닉층의 출력값을 의미하며, 이 결과로 가중치 W6가 어떻게 조정되는지 확인할 수 있음.
2-11. [참고] Backpropagation 쉽게 이해하기
산을 내려가는 것만 중요한 게 아니라, 잘못 내려갔다면 다시 올라가서 어디가 틀렸는지 수정해야 진짜 좋은 길을 찾을 수 있음.
| 단계 | 설명 | 비유 |
| 오차 계산 | 실제값과 예측값을 비교해 오차 계산 | 산 아래에 도착했는데 목표 지점과 다름 |
| 오차 전파 | 오차가 어디서부터 시작됐는지 거꾸로 따라 올라감 | 왔던 길을 되짚어 올라가기 |
| 기울기 계산 | 각 지점(가중치)에서 방향과 조정 정도를 확인 | 돌이 많아 느려진 건지, 길이 꼬인 건지 원인 파악 |
| 가중치 업데이트 | 계산한 기울기 방향에 따라 조금씩 값을 수정 | 다음에 내려갈 때는 더 나은 길로 |
Backpropagation의 3단계 요약: ① 내려가면서 길 찾기(Gradient Descent) → ② 잘못된 길이면 되짚어 올라가기(오차 역전파) → ③ 올라가면서 틀린 지점(가중치)을 수정하기.
2-12. [참고] 가중치 업데이트 정리
공식 *Wt = Wt - η × ∂E/∂Wt에서 Wt는 현재 가중치, η는 학습률(한 걸음의 거리), ∂E/∂Wt는 기울기(경사면의 기울기), 새 Wt는 업데이트된 가중치를 의미함.
- 보폭은 상황에 맞게: 이미 자주 가본 방향은 보폭을 줄여 세밀하게 탐색.
- 방향을 더 똑똑하게: 이전에 이동하던 방향을 기억해서 다음 이동 방향을 정함.
이 두 아이디어가 이어지는 Adam Optimizer의 기본 발상이 됨.
2-13. Optimizer — Adam
Adam은 SGD처럼 기울기로 가중치를 업데이트하지만, 파라미터마다 서로 다른 학습률을 자동으로 계산·저장하는 알고리즘임.
Optimizer 발전 계보(간단 정리):
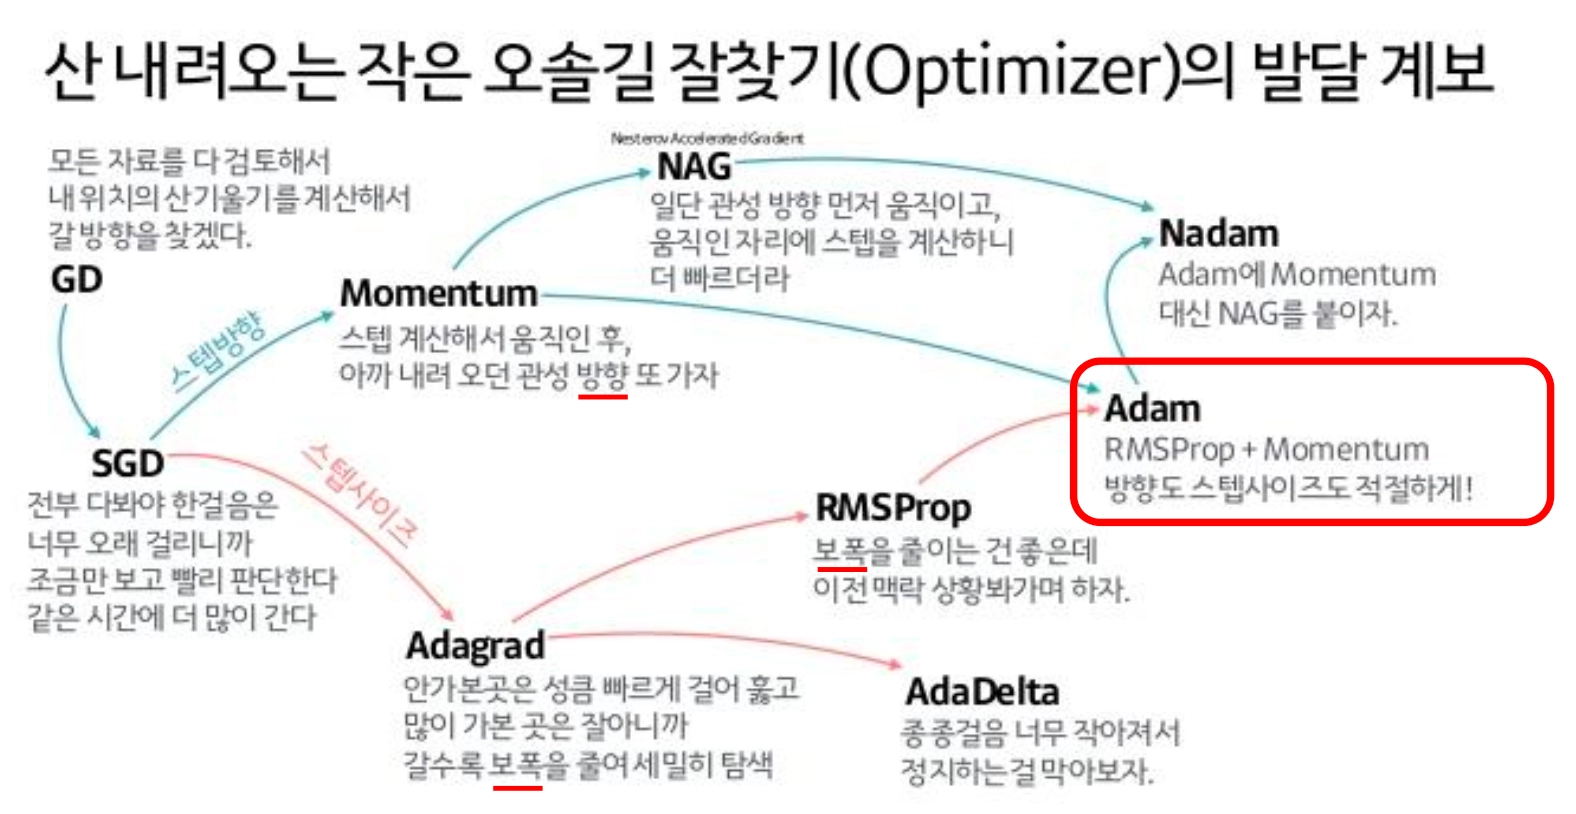
결론적으로 Adam은 방향 기억(Momentum)과 상황별 보폭 조절(Adagrad/RMSProp)이라는 두 아이디어를 결합한 방법으로, 더 빠르고 흔들림 없이 Global Minimum에 수렴하도록 함.
2-14. [참고] Adam Optimizer 쉽게 이해하기
- Gradient Descent는 현재 위치의 경사만 보고 내려가는 단순한 방식.
- Adam은 지금까지 내려온 경로의 방향성(피로도)과 그 변동 폭까지 함께 고려해서, 지형이 울퉁불퉁해도 더 빠르고 덜 흔들리며 내려감.
- 등산객이 고려하는 두 가지: 지금까지 어느 방향으로 가고 있었는가(방향 기억 = 기울기의 평균), 그 방향이 얼마나 들쭉날쭉했는가(변동 크기 = 기울기 제곱의 평균).
Adam의 진행 흐름: ① 현재 기울기 계산(지금 발밑의 경사 확인) → ② 방향 계산(지금까지 내려온 길을 종합해 속도·방향 결정) → ③ 변동 계산(지금까지의 발걸음이 얼마나 들쭉날쭉했는지 누적 기록) → ④ 업데이트(균형을 잡으며 빠르게 내려감)
2-15. Optimizer 비교 실험 결과
- Alec Radford의 시각화(2015): SGD, Momentum, NAG, Adagrad, Adadelta, RMSProp의 이동 경로를 등고선 위에서 비교하면, 알고리즘마다 최소값에 도달하는 경로와 속도, 안장점(saddle point) 근처에서의 움직임이 서로 다르게 나타남.
- Adam 논문(2017, "A Method For Stochastic Optimization")의 실험: 3D 손실 표면에서 Gradient Descent, Momentum, Nesterov, AdaGrad, AdaDelta, RMSProp, Adam의 수렴 경로를 비교했을 때와, MNIST 다층 신경망(+Dropout)에서 학습 비용(training cost) 감소 추이를 비교했을 때 모두 Adam이 가장 빠르고 안정적으로 낮은 손실값에 도달함을 보여줌.
2-16. Gradient Vanishing & Exploding
Backpropagation 과정에서 기울기의 크기가 지나치게 작아지거나 커져서 학습이 제대로 이루어지지 않는 현상.
| 구분 | Gradient Vanishing | Gradient Exploding |
| 현상 | 레이어를 거칠수록 기울기가 점점 작아져 초기 레이어가 거의 학습되지 않고, 전체 모델 성능이 하락함 | 레이어를 거칠수록 기울기가 지나치게 커져 가중치 업데이트가 과도해지고, 모델이 최적값에 수렴하지 못하고 발산할 수 있음 |
| 발생 원인 | Sigmoid, Tanh처럼 0에 가까운 값이 역전파 과정에서 계속 곱해지며 기울기가 점점 작아짐 → 결국 가중치가 업데이트되지 않고 학습이 멈춤 | 신경망이 매우 깊거나 초기화가 잘못된 경우, 특정 레이어의 큰 기울기가 역전파 과정에서 더욱 커짐 |
| 해결 방법 | ReLU(양수 영역에서 기울기가 일정), Batch Normalization | Gradient Clipping(기울기가 임계값을 넘으면 해당 값으로 제한) |
2-17. [참고] Gradient 관련 개념 총정리
| 개념 | 대상 | 목적 | 장점 | 단점 |
| Gradient Descent | 가중치 업데이트 방법 | 손실함수의 기울기에 따라 가중치 업데이트 | 단순한 원리로 파라미터 최적화 | Learning Rate 설정에 따라 너무 느리게 수렴하거나 발산할 수 있음 |
| Learning Rate | 가중치 업데이트 속도 | 기울기 크기에 따른 가중치 변화량 조절 | 학습 속도를 조절해 수렴을 가능하게 함 | 잘못 설정하면 학습 실패의 원인이 될 수 있음 |
| Gradient Vanishing | 기울기 | 신경망이 깊을 때 기울기가 사라져 학습이 멈추는 현상 설명 | 학습이 멈추는 원인을 설명해줌 | 기울기가 0에 가까워져 학습이 거의 이루어지지 않음 |
| Gradient Clipping | 기울기 | 기울기 폭발을 방지해 학습 안정성 유지 | 학습 안정성 보장, 기울기 폭발 방지 | 임계값을 너무 작게 잡으면 학습 속도가 느려짐 |
| Gradient Decay | 가중치 | 과적합 방지, 모델의 일반화 성능 향상 | 과적합 방지로 일반화 성능 향상 | 정규화 정도가 너무 크면 모델 성능이 저하될 수 있음 |
비유로 정리하면: Gradient Descent는 산을 내려가며 최적 지점을 찾는 과정, Learning Rate는 등산 중 걸음 크기를 조절하는 것(너무 크면 넘어지거나 목표를 지나치고, 너무 작으면 시간이 오래 걸림), Gradient Vanishing은 짙은 안개로 길이 보이지 않아 학습이 잘 안 되는 상황, Gradient Clipping은 가파른 경사에서 줄로 제한해 넘어지지 않게 하는 것, Gradient Decay는 배낭 무게를 줄여 가볍게 등산하는 것에 비유할 수 있음.
2-18. Dropout
Hidden Layer의 뉴런 일부를 무작위로 골라 학습에서 제외(삭제)시키면서 학습을 진행하는 방법으로, 특정 뉴런에 치우치지 않고 골고루 학습되는 효과를 얻음.
- Training 단계: 매번 삭제할 뉴런을 무작위로 선택.
- Testing 단계: 학습한 모델의 실제 결과를 확인해야 하므로, 모든 뉴런에 신호를 전달하여 확인함(뉴런을 삭제하지 않음).
- 실험 결과 그래프(classification error 기준)에서도 Dropout을 적용했을 때(With dropout)가 적용하지 않았을 때(Without dropout)보다 더 낮은 오차로 수렴하는 것으로 나타남.
3. 데이터 구조
3-1. Deep Learning Goal — 무엇을, 언제까지 학습시킬까
딥러닝 학습에서 반드시 결정해야 하는 두 가지 질문과 그 해법:
- 무엇을, 언제까지 공부시킬지: 정답(Y)에 최대한 가까워지도록 가중치를 학습시키는 것이 목표이며, 이는 Gradient Descent(Loss Function)로 구현됨. 다만 Overfitting이 발생하기 직전까지만 학습해야 하며, 이를 위해 Dropout이나 조기 종료(early stopping) 같은 학습 중단 기법을 사용함.
- 학습 데이터가 너무 클 때 어떻게 할지: 데이터를 작은 묶음(Batch, Mini-batch)으로 나누어 학습시키며, 이는 데이터의 잉여성(input이 달라져도 output의 본질은 크게 바뀌지 않는 성질)에 기반함. 또한 전체 데이터셋을 여러 번(Epoch) 반복 학습시키면 데이터의 특징을 더 잘 반영할 수 있음.
3-2. Batch — 학습 데이터셋을 어떻게 구성할까
- Batch Size = 100인 경우: 100문제를 한 번에 모두 풀고 정답과 비교한 뒤, 가중치를 1번만 업데이트함.
- Batch Size = 10인 경우: 10문제씩 나누어 풀고 정답과 비교하며, 10개 묶음마다 가중치를 업데이트하므로 총 10번 가중치가 업데이트됨.
- 즉 Batch Size가 작을수록 가중치 업데이트가 더 자주 일어나 학습을 더 꼼꼼하게 진행할 수 있음.
3-3. Batch & Epoch
데이터의 특징이 잘 반영되도록 학습시키려면 Batch뿐 아니라 Epoch 개념이 함께 필요함.
- Epoch: 전체 시험문제 1세트를 몇 번 반복해서 풀 것인지를 나타내는 단위. 예를 들어 Epoch=20이면 시험문제 1세트를 20번 반복해서 학습하는 것이며, 이전보다 학습 결과가 향상되는 효과를 기대할 수 있음.
- 다만 반복 학습에는 효과가 있지만, 과도하게 반복하면 Overfitting이 발생할 수 있어 주의가 필요함.
3-4. [참고] Mini Batch
전체 데이터에서 일부(작은/소량)를 뽑아 미니배치를 구성하고, 목적에 맞게 Data Augmentation(데이터 증강)을 적용하는 방식임. 예를 들어 얼굴 인식을 위한 딥러닝 연구(2015)에서는 원본 이미지에서 미니배치를 구성한 뒤, 샘플을 선택하고 증강을 적용해 학습용 미니배치를 만드는 절차를 사용함.
3-5. Epoch / Batch / Mini-Batch 코드로 이해하기
PyTorch 코드 예시로 세 개념의 관계를 확인할 수 있음(동일한 코드가 원본 강의자료에서 설명과 함께, 이어서 참고용으로 한 번 더 제시됨).
import torch
from torch.utils.data import DataLoader, TensorDataset

# (1) 더미 데이터셋 생성 (총 20개의 샘플, 각 샘플은 2개의 피처)
X = torch.arange(1, 41).reshape(-1, 2).float()  # shape: (20, 2)
y = torch.arange(1, 21).float().reshape(-1, 1)   # shape: (20, 1)

# (2) PyTorch Dataset 구성
dataset = TensorDataset(X, y)

# (3) DataLoader로 Mini-Batch 구성 (batch_size=5이면 mini-batch 4개)
batch_size = 5
loader = DataLoader(dataset, batch_size=batch_size, shuffle=True)

# (4) Epoch 설정
num_epochs = 3

# (5) 학습 루프 시작
for epoch in range(num_epochs):
    for batch_idx, (features, targets) in enumerate(loader):
        ...  # features, targets로 학습 진행
- Epoch: 전체 데이터셋을 한 번 학습하는(파라미터를 한 차례씩 업데이트하는) 단위. 위 예시에서 num_epochs=3이면 20개 데이터 전체를 3번 반복 학습함.
- Batch: 학습 시 한 번에 처리하는 데이터 묶음. 만약 batch_size=20이라면 전체 데이터를 한 번에 처리하므로 1 epoch당 배치는 1개뿐임.
- Mini-Batch: Batch 중에서도 batch_size가 전체 데이터보다 작은 경우를 가리킴. 위 예시처럼 총 20개 데이터에 batch_size=5이면 1 epoch당 4개의 mini-batch로 나뉘어 학습되며, 이를 통해 메모리 절약, 학습 속도 향상, gradient 안정성 확보 효과를 얻을 수 있음.
3-6. Batch Normalization
각 레이어의 입력값을 정규화해 학습을 더 빠르고 안정적으로 만드는 기법. 핵심은 손실 지형(loss landscape)을 매끄럽게 만들어 기울기를 안정시키는 것이며, 그 결과 기울기가 안정화되어(Vanishing 완화) 더 큰 학습률을 사용할 수 있고 더 빠르고 안정적으로 수렴하게 됨.
기대 효과:
- Gradient 흐름 개선: 입력 분포가 안정되어 Vanishing이 완화됨
- 학습 속도 향상: 더 큰 학습률(learning rate)을 사용할 수 있음
- 학습 안정성 확보: 각 층의 입력 분포가 일정하게 유지됨
- Regularization 효과: 과적합 방지 효과도 함께 기대할 수 있음
구조상으로는 기존 네트워크(W1→W2→...→WL, 각 가중치 뒤에 활성함수 φ가 붙는 구조)에서, 가중치와 활성함수 사이에 Batch Normalization 레이어(BNβ,γ)를 추가하는 방식으로 적용됨. 손실 지형이 매끄러워지면 경사가 지나치게 요동치거나 평평해지는 문제가 줄어들어, gradient가 안정적으로 수렴하고 더 큰 학습률에서도 학습이 수월하게 진행될 수 있음.
3-7. [참고] 데이터 구조 (R 기준 자료형 정리)
| 자료형 | 설명 |
| Scalar | 구성 인자가 1개인 벡터 |
| Vector | 1차원으로 배열된 데이터 구조(모두 동일한 유형의 자료) |
| Factor | 범주형 자료(명목형, 순서형)를 위한 구조 |
| Array | 2차원 이상의 데이터 구조 |
| List | 여러 유형, 여러 형태의 데이터를 묶은 형태 |
| Matrix | 2차원으로 배열된 데이터 구조(모두 동일한 유형의 자료) |
| Data Frame | 2차원으로 배열된 데이터 구조이나, 각 열마다 서로 다른 형태의 데이터를 지원함 |
3-8. Tensor 개념
- Vector(벡터): 1차원 배열.
- Tensor(텐서): 벡터 개념을 확장한 기하학적인 양으로, 두 개 이상의 벡터 조합으로 구성된 물리량임.
- 딥러닝이 선형 관계를 넘어 복잡한 비선형 관계를 학습하려면, 데이터를 다차원 공간(1D~6D 이상의 Tensor)으로 표현해 더 많은 정보를 효율적으로 학습할 수 있어야 함.
3-9. 차원별 텐서
- 0D-Tensor(Scalar): 구성 인자가 1개인 값. 예: x = 1
- 1D-Tensor(Vector): 숫자들이 일렬로 나열된 1차원 배열. 예: x = [1, 2, 3]
- 2D-Tensor(Matrix): 행과 열로 구성된 2차원 배열. 각 행이 데이터 포인트를, 각 열이 그 포인트의 특성을 나타냄. 예: x = [[1,2],[3,4]]
- 3D-Tensor: 여러 개의 행렬을 하나의 묶음으로 포함하는 3차원 배열. 대표적으로 컬러 이미지가 [가로, 세로, 채널] 형태로 표현되며, 채널에는 RGB 정보가 담김.
- 4D-Tensor: 여러 개의 3D 텐서를 포함하는 4차원 배열. 대표적으로 동영상 데이터가 [프레임 수, 가로, 세로, 채널] 형태로, 3D 텐서들이 시간(프레임) 축을 따라 나열된 구조임.
3-10. 이미지로 보는 텐서 Shape
- MNIST 손글씨 숫자 이미지(28×28 픽셀)를 예로 들면, 각 픽셀이 밝기(색상) 값을 가지는 하나의 28×28 행렬로 표현할 수 있음.
- 640×640 픽셀의 컬러 이미지를 예로 확장하면:
- 빨강(R) 채널의 첫 번째 행만 떼어보면 [R(1,1), R(1,2), ..., R(1,640)]처럼 길이 640인 1D-Tensor가 됨 (Shape: (640))
- R 채널 전체(640개 행)를 모으면 2D-Tensor가 되어 Shape은 (640, 640)이 됨(640×640개의 픽셀값을 가짐)
- 여기에 R, G, B 세 채널을 함께 묶으면 3D-Tensor가 되고 Shape은 (640, 640, 3)이 됨
3-11. Tensor Shape
Tensor Shape은 데이터가 배열로 어떻게 구성되어 있는지, 각 차원이 몇 개의 요소를 포함하는지를 순서대로 나타낸 정보임.
| 구분 | 1D-Tensor | 2D-Tensor | 3D-Tensor |
| 정의 | 1차원의 길이 | X-Y 두 축의 크기(길이) | X-Y-Z 세 축의 크기(길이) |
| Shape 표기 | (길이) | (가로 크기, 세로 크기) | (가로 크기, 세로 크기, 채널 수) |
| 예시 | Shape:(640) — 길이 640인 1차원 배열, 값 640개 포함 | Shape:(640,640) — 640개 행과 640개 열, 픽셀값 640×640개 | Shape:(640,640,3) — 640×640 이미지에서 픽셀이 R,G,B 3개 채널을 갖는 3차원 배열 |
3-12. [참고] Tensor Shape 쉽게 읽기
예: [[[A],[B],[C]],[[D],[E],[F]]]의 Shape을 구하는 순서:
- 가장 바깥쪽 대괄호부터 확인 → 첫 번째 차원의 크기 = 2 (내부 원소가 2개)
- 그 다음 차원의 크기 확인 → 두 번째 차원의 크기 = 3
- 그 다음 차원의 크기 확인 → 세 번째 차원의 크기 = 1
→ 최종 Shape: (2, 3, 1)
추가 예시: [[A,B,C],[D,E,F]]는 첫번째 차원 크기 2, 두번째 차원 크기 3이므로 Shape (2, 3). [A,B,C,D]는 첫번째 차원 크기 4인 1차원 배열이므로 Shape (4,).
4. 오늘의 퀴즈 (Tensor Shape 자가 점검)
원본 강의자료에는 정답이 표시되어 있지 않아, 앞서 정리한 Tensor/Shape 개념을 근거로 직접 도출한 정답과 해설을 덧붙임.
Q1. 흑백 이미지의 Tensor 표현
흑백 이미지 한 장(가로·세로 각 128픽셀)을 2D-Tensor로 표현하고자 할 때, 텐서의 차원과 Shape은?
보기: (A) 1D-Tensor, Shape:(128) (B) 2D-Tensor, Shape:(128,128) (C) 3D-Tensor, Shape:(128,128,1) (D) 3D-Tensor, Shape:(128,128,3)
- 정답 및 해설
- 정답 (B). 흑백(그레이스케일) 이미지는 채널이 1개뿐이라 별도의 채널 차원 없이 가로×세로 픽셀 값만으로 2차원 배열을 구성할 수 있음. 문제에서도 2D-Tensor로 표현한다고 명시했으므로 Shape은 (128,128)이 정답. 다만 실무의 딥러닝 프레임워크에서는 채널 차원을 명시적으로 두어 (128,128,1)의 3D-Tensor로 다루는 경우도 흔함.
Q2. 컬러 이미지의 Tensor Shape
가로·세로 각 256픽셀인 컬러 이미지의 Tensor Shape은?
보기: (A) (256) (B) (256,256) (C) (256,256,3) (D) (3,256,256)
- 정답 및 해설
- 정답 (C). 컬러 이미지는 R,G,B 3개 채널을 가지므로, [가로, 세로, 채널] 순서로 Shape을 표기하면 (256,256,3)이 됨. (D)는 채널이 앞에 오는 표기(channel-first)로 일부 프레임워크에서 쓰이지만, 본 강의에서 사용한 [가로,세로,채널] 표기 관례상 정답은 (C).
Q3. 중첩 리스트의 Tensor Shape
다음 텐서의 Shape은?
[
  [ [[1, 2], [2, 3], [3, 4]] ],
  [ [[5, 6], [6, 7], [7, 8]] ]
]
- 정답 및 해설
- 정답 Shape:(2, 1, 3, 2). 가장 바깥쪽 대괄호 안에 원소가 2개이므로 첫번째 차원은 2. 그 각각의 내부에는 원소가 1개(리스트 하나)이므로 두번째 차원은 1. 그 안에는 [1,2],[2,3],[3,4]로 원소 3개이므로 세번째 차원은 3. 마지막으로 각 쌍은 원소 2개([1,2] 등)이므로 네번째 차원은 2. 따라서 Shape은 (2,1,3,2).
Q4. 1D-Tensor를 2D-Tensor로 변환
1D-Tensor [4, 7, 9, 1, 3, 8]을 Shape (2,3)의 2D-Tensor로 변환하면?
보기: (A) [[4,7],[9,1],[3,8]] (B) [[4,7,9],[1,3,8]] (C) [[4,9,3],[7,1,8]] (D) 변환할 수 없음
- 정답 및 해설
- 정답 (B). reshape은 원소 순서를 그대로 유지하면서 앞에서부터 지정한 형태로 채워 넣는 방식(행 우선, row-major)으로 동작함. 6개의 원소를 (2,3) 형태로 채우면 첫 행에 앞의 3개(4,7,9), 둘째 행에 나머지 3개(1,3,8)가 순서대로 들어가 [[4,7,9],[1,3,8]]이 됨.
Q5. 2D-Tensor를 3D-Tensor로 변환
2D-Tensor [[1,2,3],[4,5,6]]을 행 구조를 유지하면서 Shape (2,1,3)의 3D-Tensor로 변환하면?
보기: (A) [[[1],[2],[3]],[[4],[5],[6]]] (B) [[[1,2],[3,4],[5,6]]] (C) [[[1,2,3]],[[4,5,6]]] (D) 변환할 수 없음
- 정답 및 해설
- 정답 (C). 원래 Shape (2,3)에서 각 행(3개 원소)을 그대로 유지한 채, 행과 열 사이에 크기 1인 차원 하나를 끼워 넣으면 Shape (2,1,3)이 됨. 즉 각 행 [1,2,3], [4,5,6]을 한 겹 더 감싸 [[1,2,3]], [[4,5,6]]로 만들고 이를 다시 묶으면 [[[1,2,3]],[[4,5,6]]]이 됨.
Q6. Transpose(전치)
Shape (2,3) 텐서 [[1,2,3],[4,5,6]]을 transpose하여 Shape (3,2)로 만들면?
보기: (A) [[1,2],[3,4],[5,6]] (B) [[1,4],[2,5],[3,6]] (C) [[6,5],[4,3],[2,1]] (D) [[1,2,3],[4,5,6]]
- 정답 및 해설
- 정답 (B). Transpose는 행과 열을 서로 뒤바꾸는 연산으로, 원래 텐서의 각 열이 새로운 텐서의 각 행이 됨. 원래 첫번째 열이 [1,4], 두번째 열이 [2,5], 세번째 열이 [3,6]이므로 transpose 결과는 [[1,4],[2,5],[3,6]].
5. SUMMARY (전체 복습)
강의자료 뒷부분(SUMMARY, 슬라이드 67~80)은 앞서 정리한 핵심 개념들을 순서대로 다시 훑어보는 복습 구간으로, 새로운 내용 없이 아래 항목들을 다시 강조함 — 각 항목의 상세 설명은 위 해당 section을 참고.
- Linear Regression 재해석 5단계 개요(회귀분석 개념 → 데이터 구조 → 가설 수립 → 손실함수 정의 → 모델 최적화)
- Statistics vs Deep Learning 비교, feat. Activation Function, ReLU
- DL 최적화 흐름(Forward/Back Propagation), Learning Rate
- [참고] Gradient Descent의 Local Minimum 한계
- [참고] Adam Optimizer 쉽게 이해하기
- Dropout, Deep Learning Goal(무엇을 언제까지 학습시킬지)
- Epoch/Batch/Mini-Batch 코드 예시, Batch Normalization
'STUDYING' 카테고리의 다른 글
| [STUDYING] 35. 쿠버네티스 이해 및 애플리케이션 배포_Day1_핵심 정리 (0) | 2026.09.07 |
|---|---|
| [STUDYING] 34. 데이터분석 및 AIOps_머신러닝 및 딥러닝 이해_C_핵심정리 (0) | 2026.09.02 |
| [STUDYING] 32. 데이터분석 및 AIOps_머신러닝 및 딥러닝 이해_A_핵심정리 (0) | 2026.09.02 |
| [STUDYING] 31. sLLM 구현 및 Fine Tunning_Day2_핵심 정리 (0) | 2026.08.31 |
| [STUDYING] 30. sLLM 구현 및 Fine Tunning_Day1_핵심 정리 (0) | 2026.08.28 |


